模型量化,简单来说,就是把 AI 模型原本使用的高精度数据,转换成更低精度的数据格式,从而减少模型占用的显存和计算资源。常见的量化方式包括 FP16、BF16、INT8、INT4 等。现在很多大模型在部署和推理时都会使用量化技术,核心目的之一就是降低显存占用。
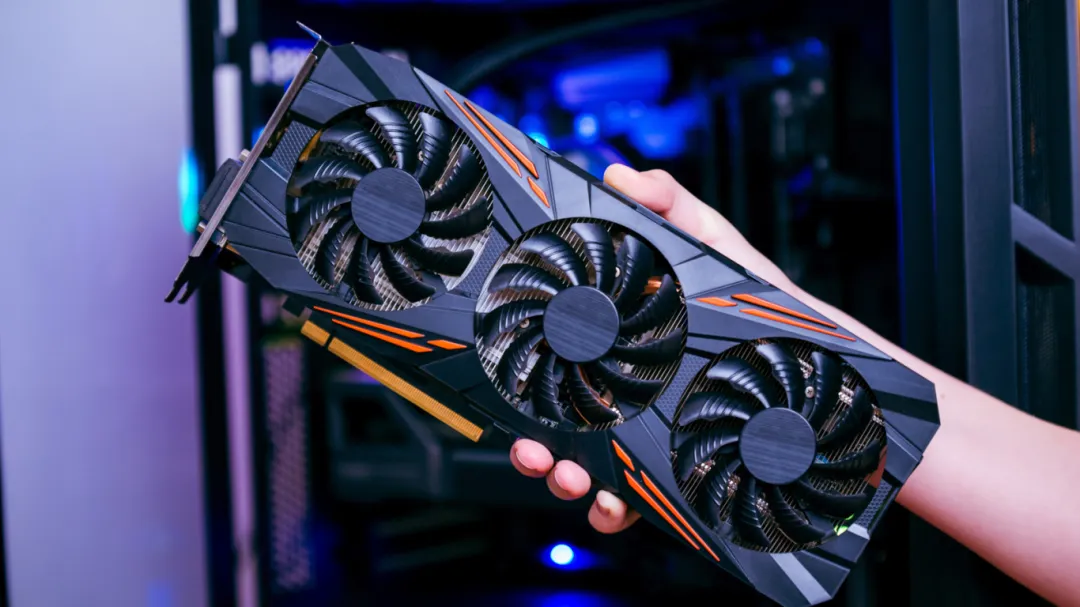
要理解量化为什么可以省显存,首先要知道模型参数本身需要占用存储空间。比如一个模型有 70 亿个参数,如果每个参数使用 FP16,也就是 16 位数据存储,那么仅模型参数就需要大约 14GB 显存。如果使用 INT8,每个参数只需要 8 位,理论上参数占用空间就可以降低到约 7GB;如果进一步使用 INT4,每个参数只需要 4 位,理论上的参数存储空间还能降低到约 3.5GB。
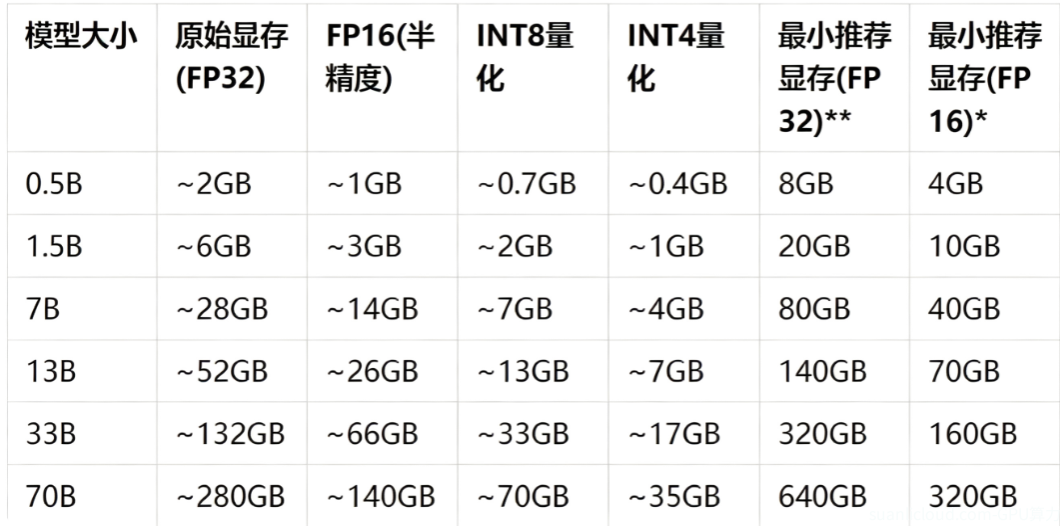
所以,量化降低显存的核心原因其实很直接:单个参数需要存储的比特数减少了。
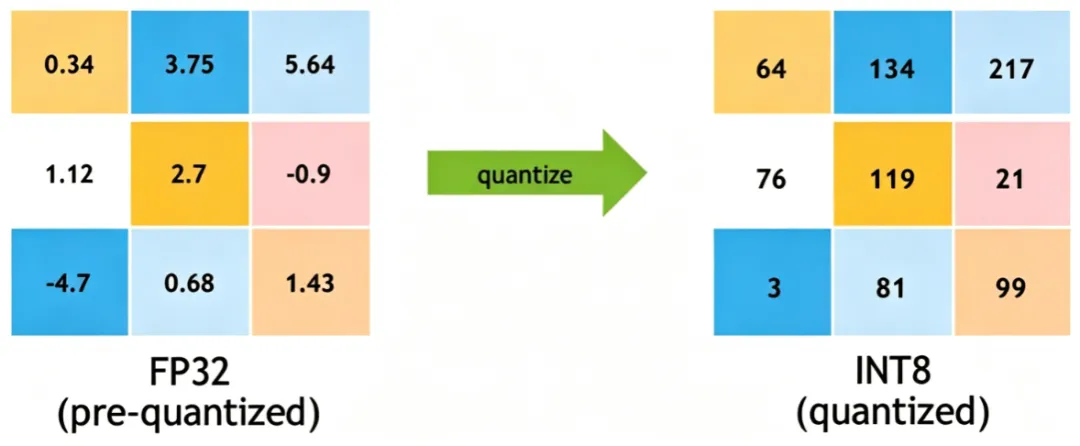
不过,量化并不是简单地把数字变小,而是需要对模型参数进行重新编码。以 FP16 转 INT8 为例,原来的浮点数会经过缩放、映射等处理,转换成整数形式。模型运行时,再通过相应的计算方式还原或近似得到原来的数值范围。
这里需要注意,量化虽然可以明显降低显存,但也可能带来一定的精度损失。因为低精度数据能够表达的数值范围和精细程度更有限,所以从 FP16 降到 INT8,甚至 INT4 后,模型输出可能会出现一定变化。量化程度越高,通常越需要关注模型精度。
另外,模型显存并不只有参数这一部分。实际运行大模型时,还会产生 KV Cache、中间激活值以及其他运行时数据。因此,量化之后虽然参数显存明显下降,但最终需要多少显存,还要看模型规模、上下文长度、并发量以及具体推理框架。
对于企业部署大模型来说,量化最大的价值就是让原本需要较大显存的模型,可以运行在显存更小的 GPU 上,同时还能提高单张 GPU 能够承载的模型数量。尤其是在 INT8、INT4 等低精度量化技术成熟之后,大模型部署对显存容量的要求可以明显降低。
所以可以把模型量化理解成一个非常明确的技术过程:通过降低模型参数的数据精度,减少每个参数占用的存储空间,从而降低显存需求。但量化并不是完全没有代价,需要在显存占用、推理速度和模型精度之间进行合理选择。