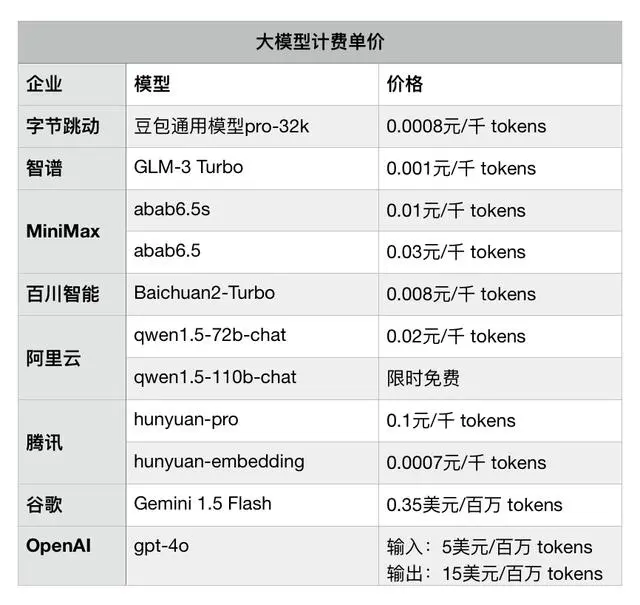
AI 模型的 API 价格,通常分为输入 Token 和输出 Token 两部分,两者的收费标准往往存在明显差异。了解这两项费用,才能更准确地评估 AI 应用的使用成本。
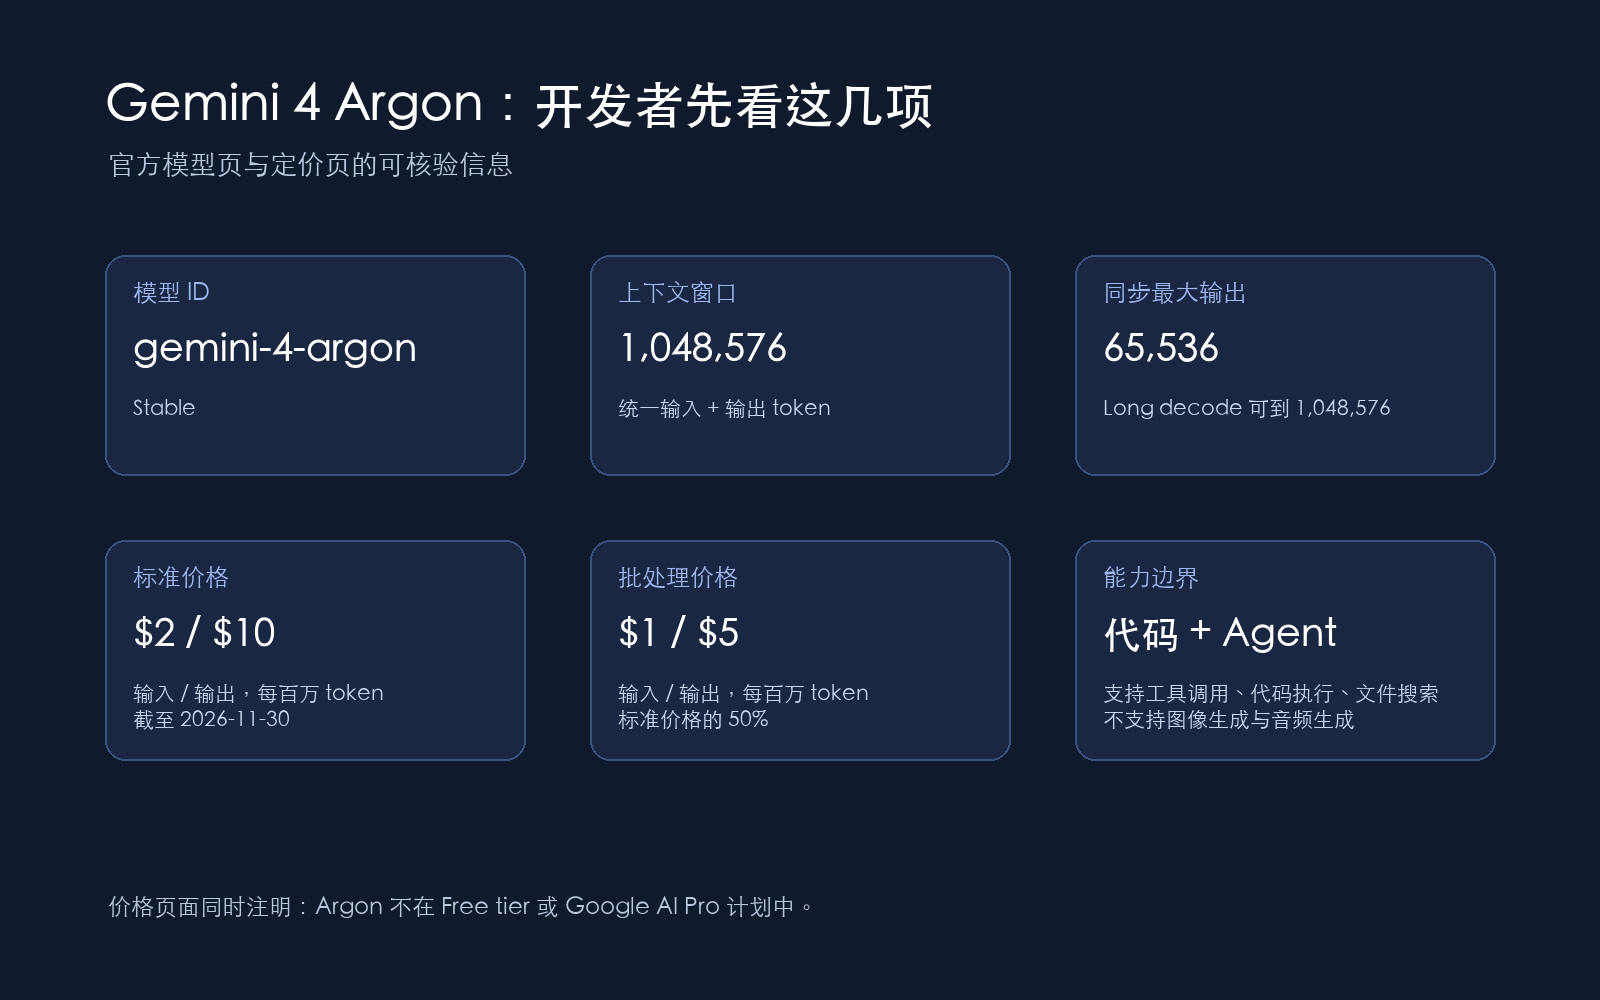
Google 于 10 月 13 日发布 Gemini 4 Argon,面向开发者和企业用户,重点支持编程、金融、法律、网络安全和科学研究等复杂任务。Google 公布的 API 起始价格为每百万输入 Token 2 美元、每百万输出 Token 10 美元。按照这一价格,输出 Token 的单价是输入 Token 的 5 倍。那么,为什么同一个 AI 模型,输入和输出的收费会有这么大的差别?
首先,需要了解什么是输入 Token 和输出 Token。输入 Token 是用户发送给模型的内容经过分词后形成的计费单位,包括提问、上传的文本以及部分上下文信息。输出 Token 则是模型生成的回答,包括文字、代码等内容。不同模型的分词规则有所不同,因此 Token 数量不完全等同于字数。
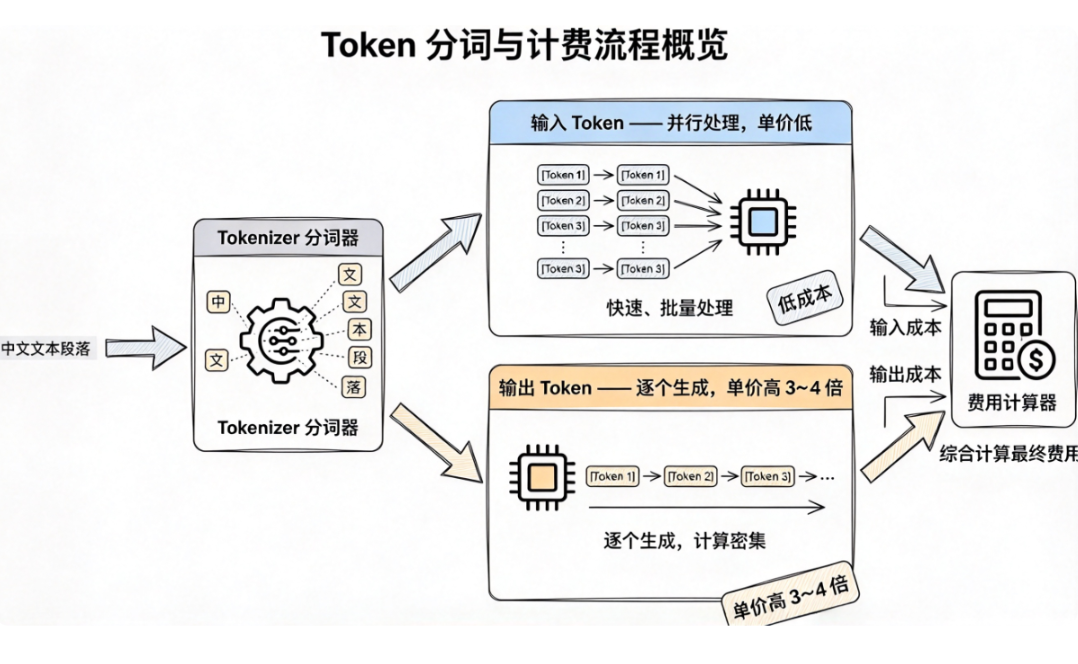
输入和输出收费不同,主要与模型的计算过程和资源消耗有关。处理输入时,模型需要读取和分析用户提供的内容;生成输出时,模型通常需要逐步预测并生成后续内容,持续进行推理计算。当回答涉及复杂代码、长篇分析或多步骤任务时,生成过程可能需要消耗更多计算资源。因此,许多模型会对输出 Token 设置更高的单价。不过,具体价格仍取决于模型架构、推理效率、服务定位以及厂商的定价策略,并不是所有模型都采用相同的收费比例。
以 Gemini 4 Argon 的上述价格为例,如果一次请求使用了 1 万输入 Token 和 2000 输出 Token,那么输入费用为 0.02 美元,输出费用为 0.02 美元,合计 0.04 美元。可以看到,虽然输出 Token 的单价更高,但实际费用还需要结合输入和输出的数量计算。
企业在选择 AI 模型时,不能只看每百万 Token 的报价,还要考虑实际任务需要消耗多少 Token、模型回答质量、响应速度以及缓存等计费规则。对于大量调用接口的业务,还可以通过缩短不必要的提示词、复用上下文缓存、控制回答长度等方式降低成本。只有结合实际使用量和业务需求进行测算,才能判断一个模型是否真正划算。