PyTorch 是目前 AI 开发领域广泛使用的深度学习框架之一,主要用于构建、训练和运行人工智能模型。从大语言模型到图像识别系统,许多 AI 项目的开发过程都离不开它。
那么,PyTorch 到底是什么?它在 AI 开发中发挥着什么作用?
简单来说,PyTorch 是由 Meta 及其研究团队发起的开源深度学习框架,能够帮助开发者使用 Python 编写 AI 程序,并完成神经网络的构建、模型训练和推理等工作。它提供了丰富的计算工具,可以处理大量数据,并支持调用 GPU 进行并行计算,从而提高模型训练和运行的效率。
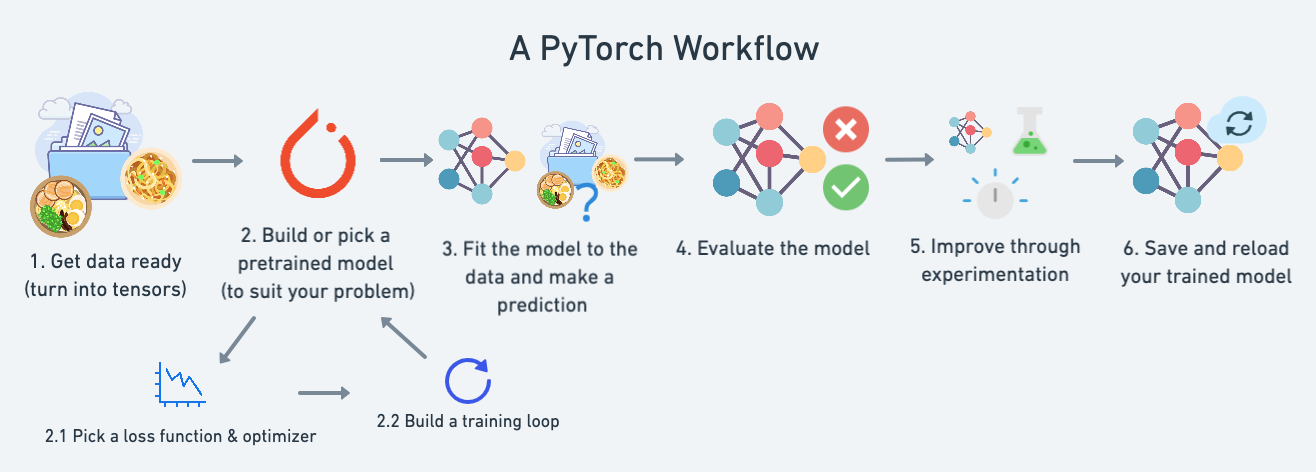
要理解 PyTorch 的作用,首先需要了解 AI 模型是怎么训练出来的。以大语言模型为例,模型需要读取大量文本数据,通过不断计算预测结果与实际结果之间的误差,再根据误差调整内部参数。这个过程涉及大量数学运算,包括矩阵乘法、梯度计算和参数更新。如果完全从头编写这些功能,开发工作会非常复杂。
PyTorch 将这些常用功能整合在了一套框架中。开发者可以利用它搭建神经网络结构,自动计算训练所需的梯度,并通过优化器更新模型参数。同时,PyTorch 支持自动微分机制,可以自动完成复杂的梯度计算,减少手动编写数学运算代码的工作量。
另一个重要原因是,PyTorch 能够充分利用 GPU 的计算能力。AI 模型训练通常涉及海量矩阵运算,CPU 虽然也能完成这些任务,但在适合并行处理的大规模计算场景中,GPU 通常具有明显的性能优势。借助 PyTorch,开发者可以将数据和模型运算部署到 GPU 上执行,并使用多张 GPU 进行分布式训练,以满足更大规模模型的计算需求。
此外,PyTorch 的应用范围也不局限于模型训练。在模型开发完成后,它还可以用于推理部署,让训练好的模型根据用户输入生成回答、识别图像或完成其他任务。目前,许多开源 AI 模型和开发工具都提供了 PyTorch 相关支持,这也降低了开发者使用和改进模型的门槛。
不过,PyTorch 并不是 AI 开发的唯一选择。TensorFlow、JAX 等框架同样具有广泛的应用场景。不同框架在开发体验、性能优化和部署方式上各有特点,具体选择需要结合项目需求。
总体来说,PyTorch 之所以受到 AI 开发者的广泛使用,主要是因为它简化了模型构建和训练流程,能够调用 GPU 完成高强度计算,并拥有成熟的开源生态。对于大模型研发、AI 应用开发以及算力资源使用来说,理解 PyTorch 的基本原理,有助于进一步理解模型训练为什么需要 GPU,以及 AI 算力究竟用在了哪些环节。