
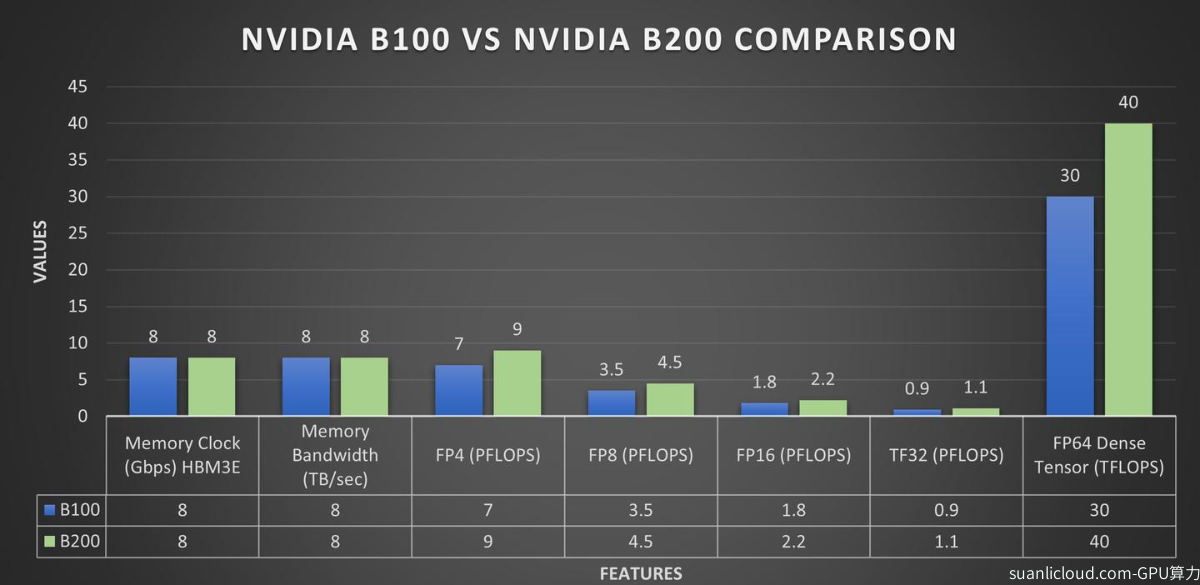
B200到底有多强?简单来说,它是 NVIDIA Blackwell 架构中的核心 AI GPU,主要面向大模型训练和推理。相比上一代 H100,B200在显存、显存带宽、低精度计算和多GPU互联方面都有明显提升。

先看最容易理解的显存。B200单颗 GPU 配备 180GB HBM3E 显存,显存带宽最高达到 8TB/s。作为对比,H100是80GB HBM3、3.35TB/s。B200不仅显存容量增加了一倍以上,带宽也提升明显。对于大模型来说,显存不仅要放模型参数,还要放 KV Cache、激活值以及计算过程中的中间数据,因此显存容量和带宽都会直接影响实际运行效率。
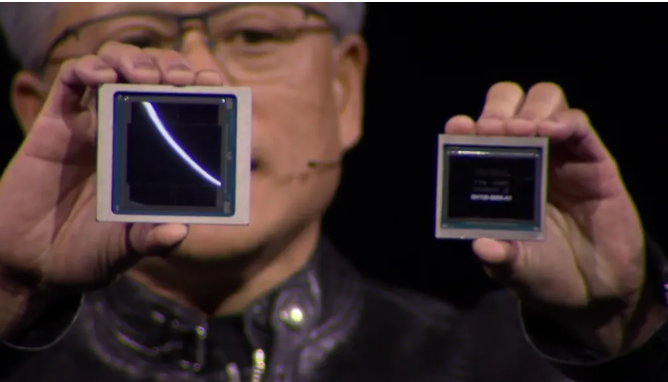
再看 AI 算力。B200支持 FP4、FP8、FP16、BF16 等多种计算精度。NVIDIA公布的规格中,单颗 B200 的 FP4 Tensor Core 峰值最高达到 9 PFLOPS级别的密集计算性能,采用稀疏计算口径则可以达到18 PFLOPS。这里需要注意,不同精度和稀疏、密集计算的统计方式不同,所以看参数时不能直接把不同厂商的数字放在一起比较。
B200还有一个重要升级,就是第五代 NVLink。AI服务器通常不是只安装一张 GPU,而是多张 GPU 同时工作。HGX B200采用8张 B200,通过第五代 NVLink和NVSwitch连接,GPU之间的带宽最高达到 1.8TB/s,整个平台的NVLink总带宽达到 14.4TB/s。这对于大模型训练中的参数同步、梯度交换和推理任务中的数据传输都非常重要。
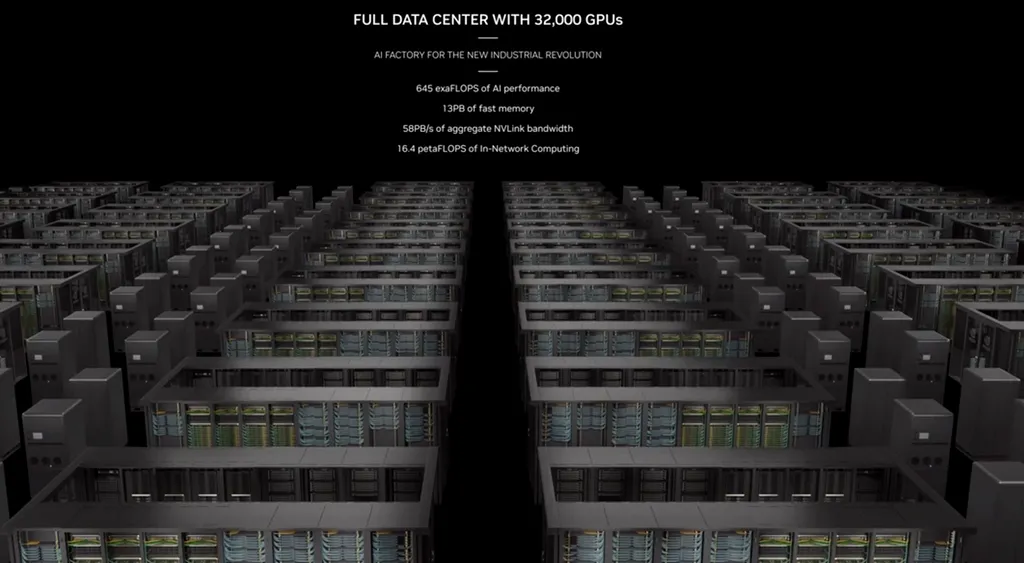
如果看整机,NVIDIA DGX B200搭载8张B200,总GPU显存达到 1.44TB。这意味着很多大型模型可以获得更大的显存空间,同时多GPU之间可以通过高速互联协同计算。DGX B200还配备400Gbps级高速网络,用于服务器之间的数据交换。
所以,B200真正值得关注的并不是单独某一个参数,而是显存、显存带宽、AI计算精度以及GPU互联能力一起提升。对于大模型训练、推理、生成式AI和高性能计算等场景,B200的核心价值就是让更大的模型能够在更高吞吐下运行。


