
模型量化,简单来说,就是把模型参数从较高精度的数据类型,转换成较低精度的数据类型,从而减少模型运行时占用的显存。它是大模型部署中比较常见的一种优化方式。
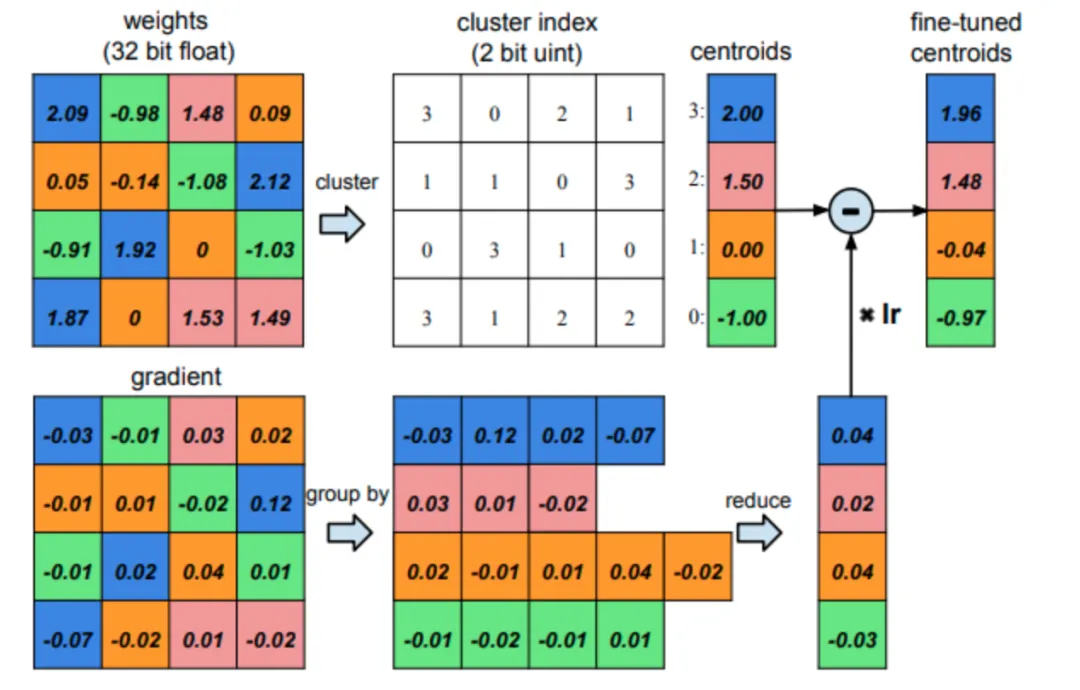
我们先看模型参数本身。AI模型在训练完成后,会保存大量参数,这些参数通常使用FP32、FP16、BF16等数据类型表示。不同数据类型占用的存储空间不同。例如,一个FP32参数需要4个字节,而FP16或BF16通常只需要2个字节。如果模型有几十亿甚至几百亿个参数,这个差距就会非常明显。
模型量化就是进一步降低参数的数值精度。例如,把FP16转换成INT8,或者进一步转换成INT4。INT8每个参数通常只需要1个字节,INT4则只需要半个字节。这样一来,模型参数本身需要存储的空间就会明显减少。
举个简单的例子,一个拥有70亿参数的模型,如果使用FP16存储,仅模型参数就大约需要14GB显存。如果使用INT8,参数存储空间理论上可以降到约7GB;如果使用INT4,则理论上可以进一步降到约3.5GB。当然,实际运行时还需要考虑模型结构、KV Cache、框架开销以及临时计算空间,所以最终显存占用不会完全等于这个数字。
那为什么降低精度后,模型还能正常运行?
原因是很多AI任务并不一定需要所有参数都保持FP32或者FP16这样的高精度。量化会通过特定的算法,对参数数值进行压缩和重新表示,同时尽可能减少精度损失。常见的量化方式包括INT8、INT4,也有GPTQ、AWQ等针对大语言模型的量化方法。
不过,量化并不是单纯把数字变小就结束了。不同量化方案对模型精度、推理速度、显存占用以及硬件支持都有影响。有些量化方式主要针对模型权重,有些还会进一步处理激活值。实际部署时,需要根据模型大小、GPU显存、推理速度要求和业务场景选择合适的方案。
所以,模型量化最直接的作用,就是减少模型参数的数据存储空间,从而降低显存需求。对于显存有限的GPU来说,量化可以让原本无法完整加载的模型,在更小的显存环境中运行,这也是现在大模型推理中经常使用量化技术的重要原因。