
租GPU不能只看“多少钱一张卡”,真正影响使用体验和成本的,是GPU型号、显存、GPU数量、CPU和内存、存储、网络以及计费方式。
首先看GPU型号。不同GPU的算力、显存、带宽和功耗差异都比较大。常见的有A100、H100、H200、B200等。如果主要做AI推理,重点关注实际推理性能和显存容量;如果做大模型训练,还要重点关注GPU之间的通信能力以及显存带宽。不能单纯根据型号判断是否适合自己的业务。
第二个参数是显存容量。这个非常关键。模型能不能正常加载、一次能处理多大的Batch、推理时能支持多长的上下文,都和显存有关。例如24GB、48GB、80GB、141GB等规格,适用场景并不一样。如果模型本身就需要较大的显存,GPU算力再高,显存不够也无法直接使用。
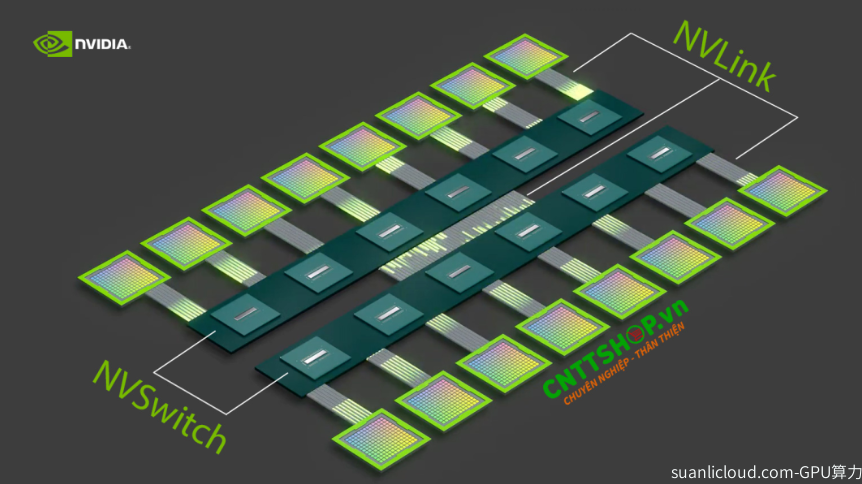
第三是GPU数量和GPU之间的互联方式。如果只租一张卡,主要看单卡性能;如果租4卡、8卡甚至更多GPU,就要关注NVLink、NVSwitch以及PCIe等连接方式。多卡训练时,GPU之间需要频繁交换数据,互联能力会直接影响训练效率。
然后看CPU、内存和存储。GPU服务器并不是只有GPU,CPU核心数、系统内存、NVMe SSD容量和读写性能,同样会影响数据加载和任务运行。如果数据集比较大,建议重点关注本地NVMe容量和磁盘性能。
网络参数也不能忽略。尤其是GPU云或者远程GPU服务器,要看公网带宽、内网带宽、延迟以及是否支持RDMA。如果需要跨服务器进行分布式训练,网络性能的重要性会明显提高。
最后一定要看计费方式和资源独占情况。GPU是独占还是共享?按小时、按月还是按量计费?是否收取存储、流量、IP和管理费用?服务器重启、系统重装、数据盘是否另外收费?这些都会影响最终成本。