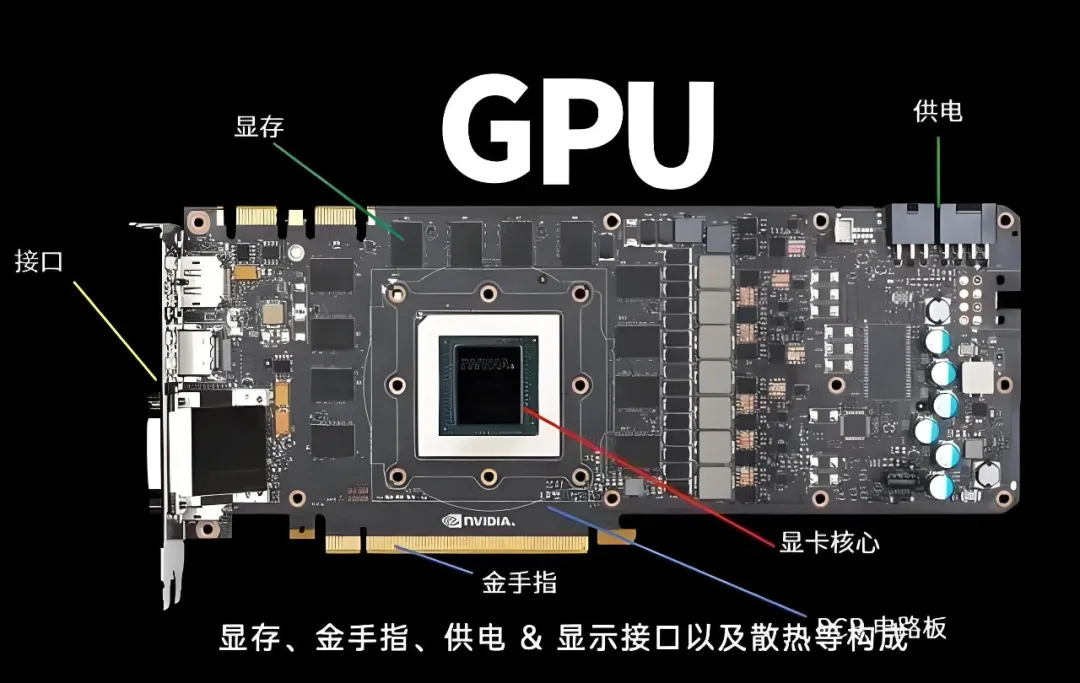
GPU利用率并不是越高越好。 在AI训练、模型推理和科学计算中,GPU长期保持高利用率通常说明资源得到了充分使用,但如果一直追求100%利用率,也可能带来性能、稳定性和成本上的问题。真正需要关注的,是GPU是否在合适的负载下保持合理利用率。
首先,GPU利用率反映的是GPU计算单元处于工作状态的时间比例。比如监控工具显示GPU利用率90%,说明统计周期内GPU大部分时间都在执行计算。但这个指标只能说明“忙不忙”,不能直接代表“效率高不高”。如果GPU利用率很高,但显存频繁读写、数据加载缓慢,或者CPU处理跟不上,整体任务速度依然可能不理想。
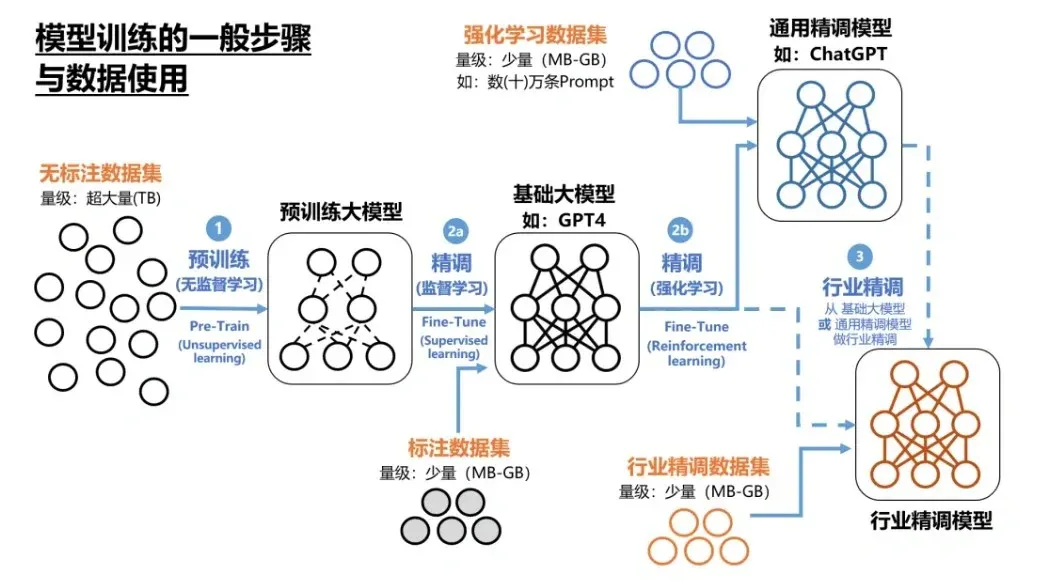
在AI训练中,这种情况比较常见。模型训练需要GPU、CPU、内存、存储和网络共同配合。如果数据读取速度不足,GPU可能出现等待;如果采用多GPU训练,还涉及GPU之间的数据同步。当某些环节成为瓶颈时,即使监控看到GPU利用率较高,也不代表整个训练任务已经达到最佳性能。
其次,长期满负载运行还需要考虑显存、温度和功耗。GPU利用率接近100%时,通常意味着计算资源处于持续高负载状态,功耗和散热压力也可能增加。如果数据中心的供电和制冷能力有限,就需要综合考虑设备稳定性和整体运行成本。
对于GPU云和GPU服务器租赁来说,利用率还直接关系到资源规划。如果一台GPU服务器长期只有20%~30%的利用率,说明资源可能存在闲置;但如果长期接近100%,又可能缺少业务高峰时的资源余量。因此,实际部署中通常会结合GPU利用率、显存占用、功耗、温度、任务延迟以及吞吐量一起分析。
比如一台8卡GPU服务器,不能只看8张卡是不是全部跑到100%。如果其中几张卡利用率很高,而其他GPU经常等待,可能说明任务调度或GPU之间的数据分配存在问题。
所以,判断GPU使用是否合理,核心不是追求一个固定的利用率数字,而是看单位时间完成了多少有效任务,以及资源是否稳定、充分地被使用。对于不同业务,合理区间也不一样。AI训练通常希望保持较高利用率,而在线推理业务则需要预留一定资源,应对突发请求。