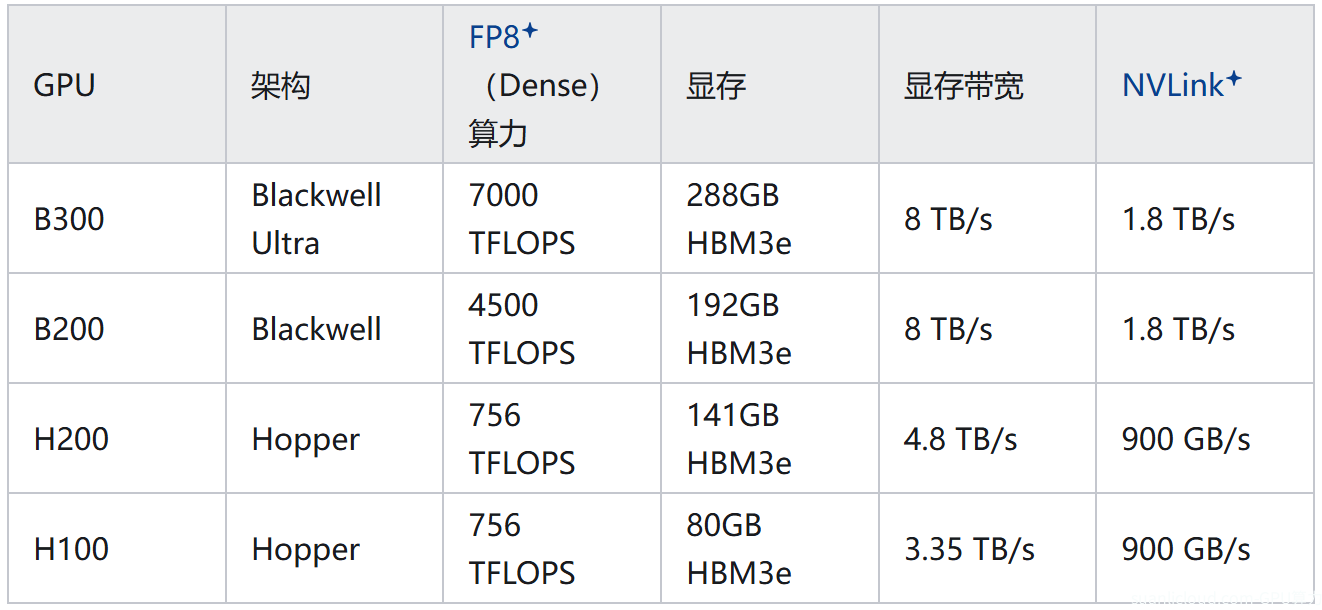
B300单张GPU拥有288GB HBM3e显存,这已经不是传统意义上的“大显存”,而是直接把单卡能够容纳的模型规模提升到了数百亿甚至上千亿参数级别。 NVIDIA官方数据显示,B300采用Blackwell Ultra架构,单GPU最高提供288GB HBM3e,显存带宽最高达到8TB/s。
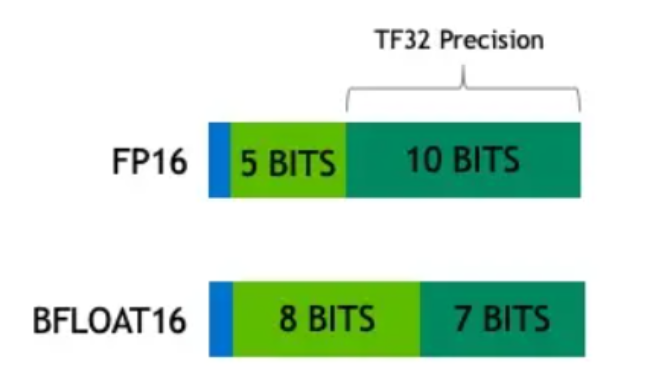
先理解一个最基本的关系:AI模型参数量越大,占用的显存通常就越多。 如果只看模型权重,FP16或BF16通常可以按照每个参数约2字节计算。
比如一个70B模型:
70B × 2字节 ≈ 140GB
因此,理论上B300的288GB显存,单卡可以把70B模型完整放进去,而且还会剩下一部分显存给KV Cache、运行框架以及其他计算数据。
如果是100B模型:
100B × 2字节 ≈ 200GB
同样可以放进一张B300。
再往上看,130B模型大约需要260GB显存,已经比较接近288GB的容量,但实际运行时还需要给KV Cache、CUDA运行环境等预留空间,所以不能简单认为“288GB就等于能跑288B参数模型”。
这也是为什么看AI GPU显存,不能直接用“显存÷2”来判断最大模型规模。
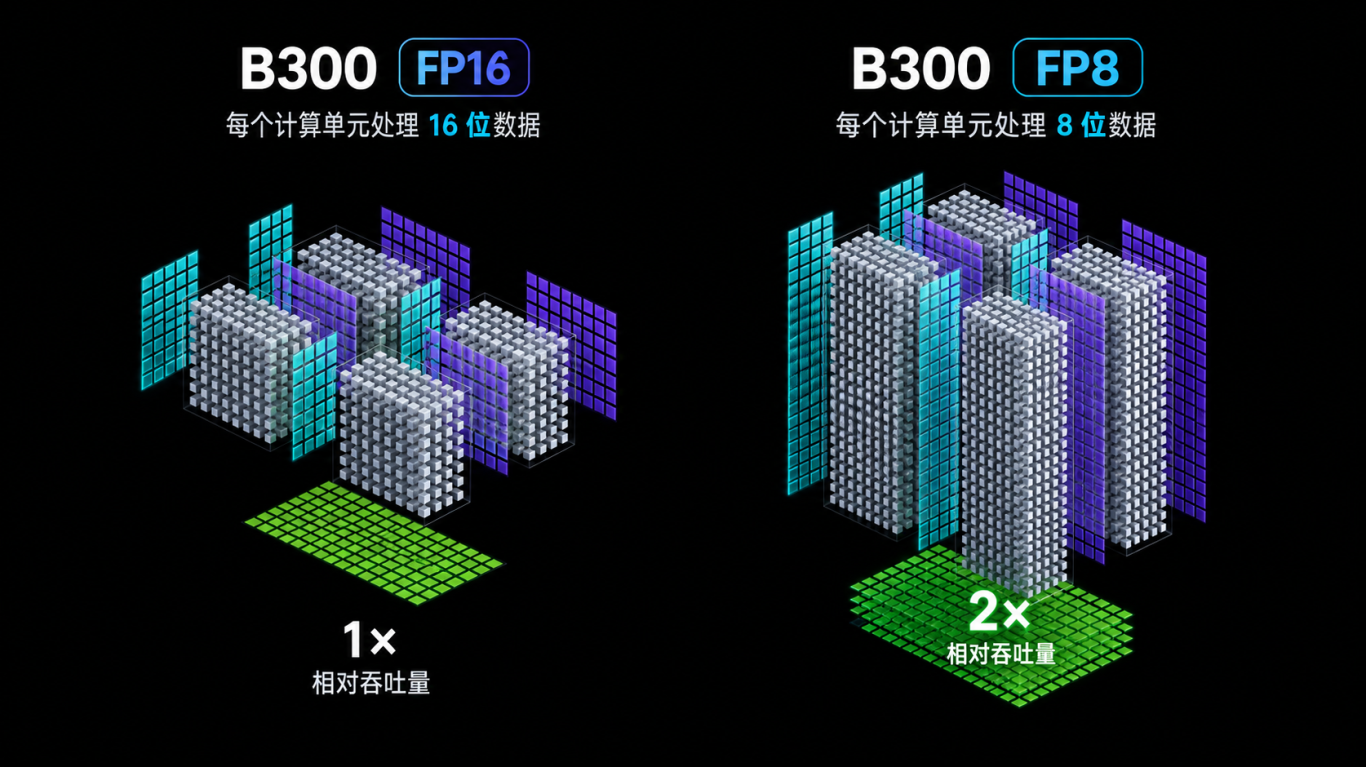
如果使用FP8,模型权重理论上只需要约1字节/参数,那么200B模型的权重本身大约只占200GB;如果进一步采用FP4等低精度格式,占用还会继续下降。NVIDIA也已经针对Blackwell Ultra提供NVFP4支持,并展示了对大型模型进行量化部署的方案。
所以,B300单卡跑70B、100B甚至200B级模型,在显存容量上都有很大的空间;300B以上模型则要根据精度、量化方式和实际运行配置判断。 NVIDIA官方资料甚至明确表示,288GB HBM3e可以让300B+参数模型在不进行显存卸载的情况下驻留在GPU显存中。
而如果不是单张B300,而是8张B300组成的HGX B300,一台服务器的GPU显存总量可以达到约2.3TB。
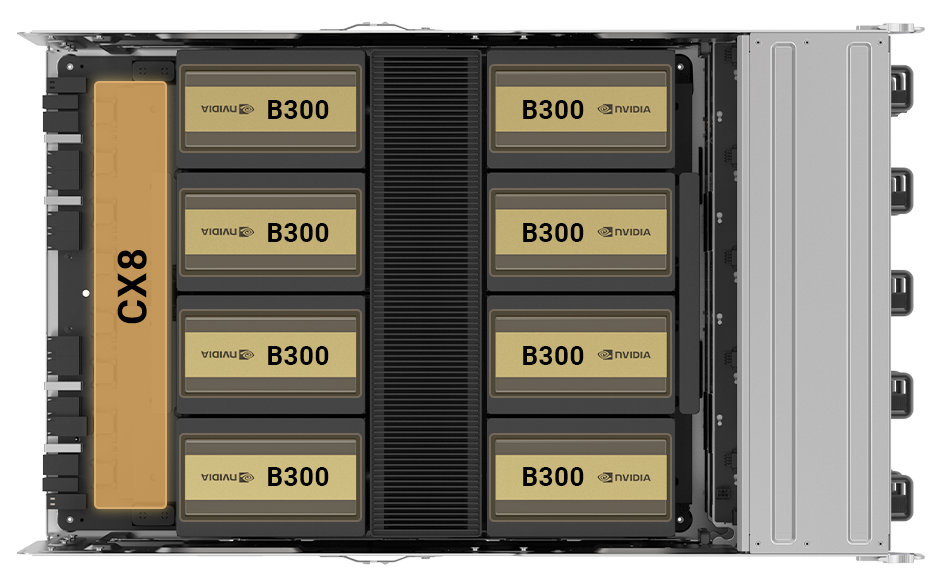
所以,B300的288GB显存真正重要的地方,不只是“容量大”,而是它让70B、100B、200B甚至更大规模模型,在单卡或单机上的部署空间明显扩大,同时也能为长上下文和高并发推理留出更多显存空间。