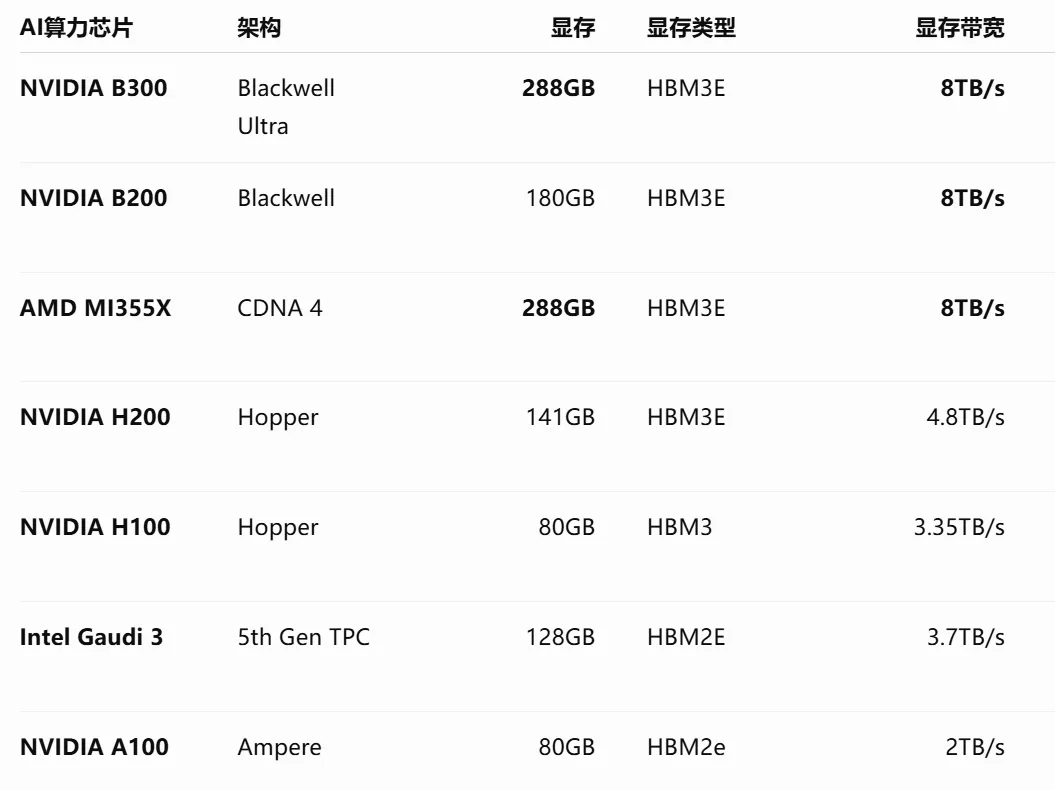
HBM,全称是 High Bandwidth Memory,也就是高带宽内存。简单来说,它是一种专门为高性能计算设计的内存技术。现在主流 AI GPU,例如 NVIDIA H100、H200、B200 等,都大量采用 HBM,核心原因就在于 AI 模型运行时不仅需要很大的显存容量,还需要 GPU 在短时间内读取和写入海量数据。
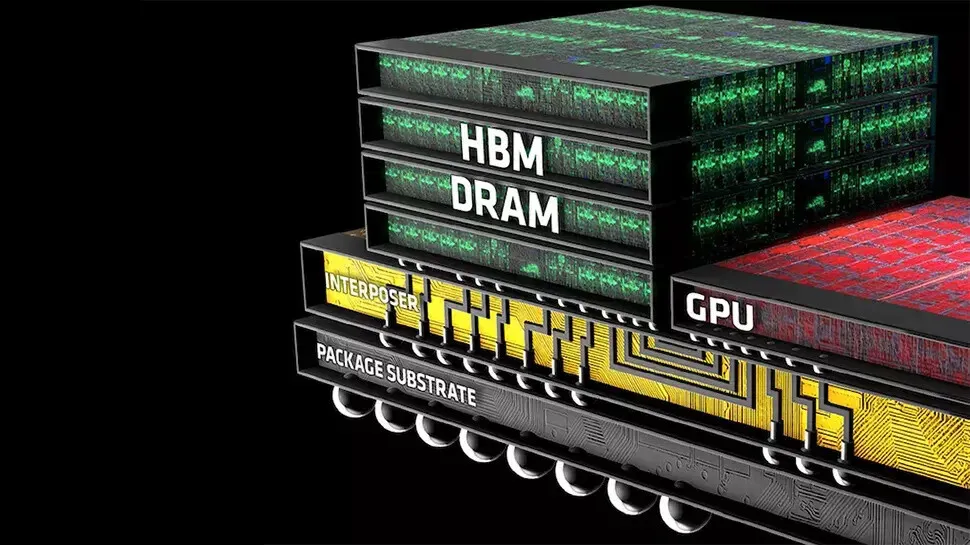
传统 GPU 显存主要使用 GDDR,而 HBM 的结构和连接方式不同。HBM 会把多层 DRAM 芯片进行垂直堆叠,再通过 TSV(硅通孔)等技术进行高速连接,并通过非常宽的接口与 GPU 连接。这样做可以在较高数据传输效率的情况下,实现非常大的内存带宽。
为什么 AI GPU 特别需要 HBM?首先是 AI 计算的数据量非常大。以大模型推理为例,GPU 在计算过程中需要不断读取模型参数、输入数据以及中间计算结果。如果显存带宽不足,GPU 的计算能力再强,也可能因为数据供给速度跟不上而降低实际利用率。
其次,AI GPU 的计算规模越来越大。现在一张高端 AI GPU 可以提供非常高的 FP16、BF16、FP8 等计算性能,对显存带宽的要求也越来越高。HBM能够提供远高于普通显存的带宽,因此更适合训练和推理大模型。
第三,HBM可以在有限的封装空间内提供较大的带宽。GPU 与 HBM 通常采用先进封装技术进行集成,GPU 和内存之间的物理距离更短,连接接口也非常宽,可以减少高速数据传输过程中受到的限制。
当然,HBM也不是只有优点。它的制造工艺、先进封装和测试要求都比较高,成本也明显高于普通显存。同时,HBM的供应能力还会受到晶圆、堆叠工艺和先进封装产能的影响,所以高端 AI GPU 的成本中,HBM本身就是一个重要组成部分。
从实际应用来看,HBM已经成为高端 AI GPU 的重要组成部分。可以简单理解为:GPU负责进行大量计算,而HBM负责持续提供这些计算需要的数据。对于 AI 训练和推理来说,计算性能和显存带宽需要同时提升,只增加 GPU 算力而不提高内存带宽,整体性能也很难充分发挥。
所以,AI GPU 普遍使用 HBM,并不是单纯为了增加显存容量,更重要的是满足大模型时代对高带宽、低延迟、高数据吞吐的需求。随着模型规模和 GPU 算力继续提升,HBM的重要性也会越来越高。