当前 AI 芯片竞争已经不只是看 GPU 有多少 TFLOPS,而是看它能不能真正支撑大模型训练和推理。NVIDIA B300,也就是 Blackwell Ultra 架构 GPU,最大的提升主要集中在算力、显存、AI 推理和多 GPU 通信几个方面。
首先是 AI 算力。B300 针对 AI 工作负载进行了专门优化,支持 NVFP4 等低精度计算。按照 NVIDIA 公布的数据,单颗 Blackwell Ultra GPU 的 NVFP4 密集计算能力最高达到 15 PFLOPS。对于现在越来越依赖推理计算的 AI 模型来说,这种低精度计算能力非常重要。尤其是在大模型推理、Agent 和长上下文任务中,可以在保证计算效率的同时提升整体吞吐。
第二个非常明显的提升是显存。B300 单 GPU 配备 288GB HBM3E,显存带宽最高达到 8TB/s。相比 H100 的 80GB HBM,显存容量提升非常明显。更大的显存意味着更多模型参数、KV Cache和中间数据可以直接放在 GPU 显存中,减少频繁的数据搬运。对于 300B 甚至更大规模的模型来说,这一点非常关键。
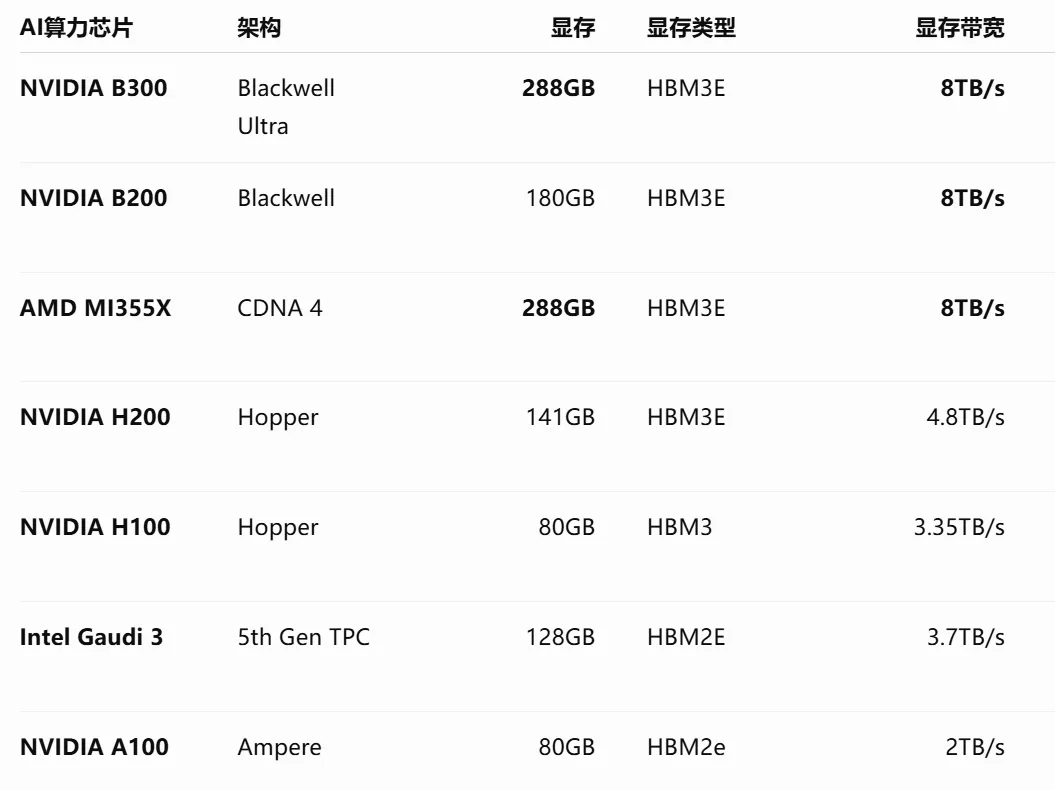
第三是注意力计算能力。现在大模型推理并不是简单地做矩阵计算,Transformer 中的 Attention 计算同样非常重要。Blackwell Ultra 针对 Attention 中的部分计算进行了硬件级优化,相关性能最高可以达到上一代 Blackwell 的 2 倍。对于长上下文和推理型模型,这种提升会更加明显。
第四是多 GPU 通信。AI 服务器很少只使用一张 GPU,B300通常会组成多卡系统。以 DGX B300 为例,一台设备搭载 8 张 Blackwell Ultra GPU,总 GPU 显存达到约 2.3TB,并通过第五代 NVLink 和 NVSwitch 实现高速 GPU 间通信,整机 NVLink 聚合带宽达到 14.4TB/s。
所以,B300真正强的地方并不是某一个参数特别高,而是算力、显存、显存带宽、Attention 加速以及 GPU 互联同时进行了升级。尤其面对大模型推理、长上下文和高并发 AI 应用时,这些能力会直接影响实际吞吐和响应速度。