AI 模型蒸馏,是一种通过教师模型的输出结果训练学生模型的技术。它可以让规模较小的模型学习大模型的部分能力,同时降低训练和部署成本。但随着 AI 商业竞争加剧,模型蒸馏也引发了争议,部分大模型厂商开始限制其他机构利用自己的模型进行蒸馏。
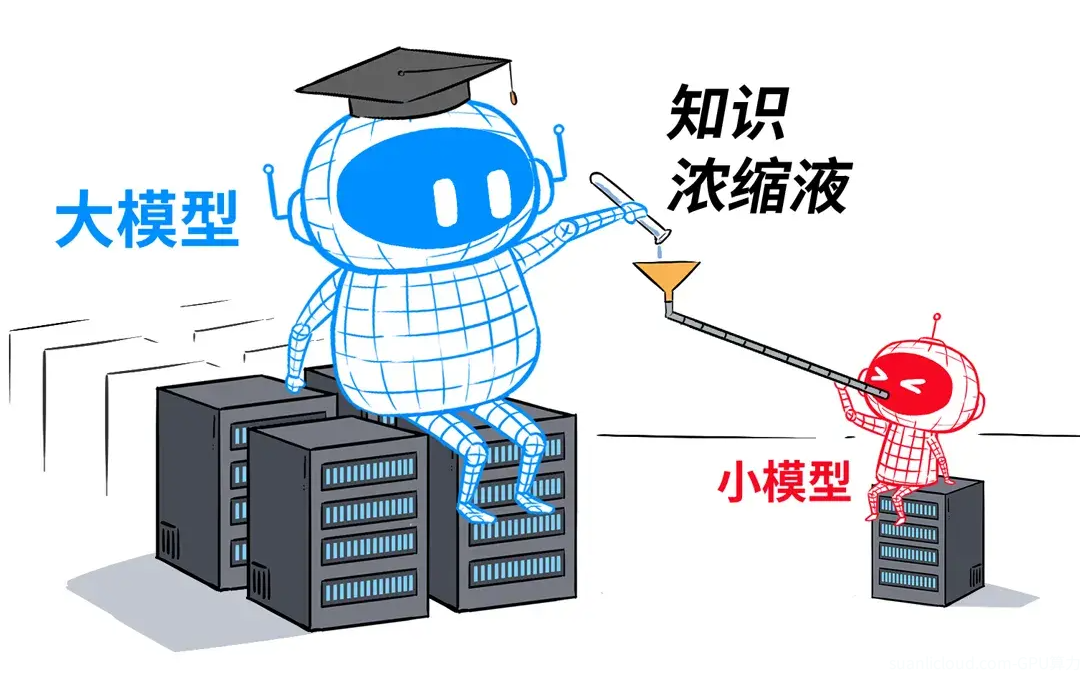
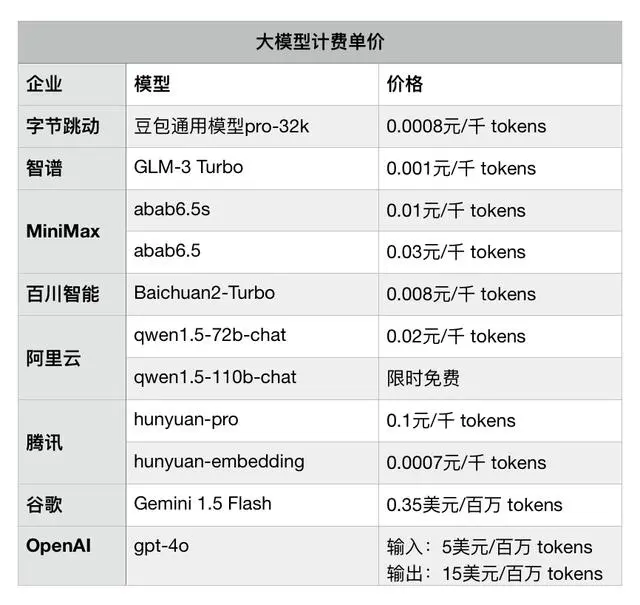
具体来说,模型蒸馏通常会先使用一个能力较强的模型作为教师模型,再通过提问、收集回答、整理训练数据等方式,让较小的模型学习这些输出结果。例如,开发者可以向大模型输入大量问题,收集它生成的答案,再用这些数据训练自己的模型,使其在特定任务中获得较好的表现。相比从头训练一个大型模型,这种方式有机会减少训练所需的数据、算力和资金投入。不过,蒸馏并不意味着能够完整复制原模型的能力,最终效果还取决于训练数据的质量、模型架构和训练方法。

为什么大模型厂商要防止其他机构蒸馏自己的模型?
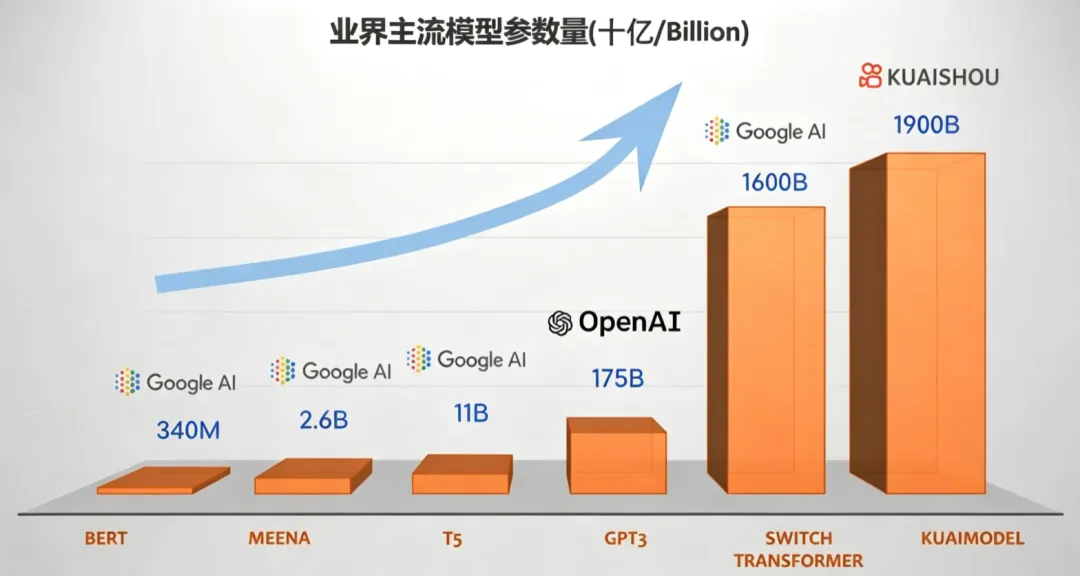
首先是商业利益问题。开发一个高性能模型需要投入大量研发资金、GPU算力和数据资源,如果其他机构通过大量调用接口获取模型输出,再训练出具有竞争力的产品,就可能降低自身研发成本,并与原模型形成直接竞争。其次是服务成本和资源占用。如果有人通过自动化程序高频调用模型接口,大规模收集回答,不仅会增加服务器和推理算力的消耗,还可能影响正常用户的使用体验。此外,厂商还需要考虑数据安全、服务条款以及模型能力被滥用等风险。
需要注意的是,模型蒸馏本身是一种正常的 AI 技术,并不等于违规行为。开发者利用自己拥有的数据和模型开展蒸馏,或者在符合许可协议的前提下使用教师模型,都属于常见的技术实践。真正存在争议的,是未经授权的大规模数据提取、违反服务条款的模型复制,以及相关行为是否侵犯知识产权。厂商通常会通过调用频率限制、异常请求检测、接口权限管理等方式降低风险。
总体来看,模型蒸馏能够帮助开发者降低模型训练和部署成本,也能推动小模型在专业场景中落地。但对大模型厂商而言,如何在开放服务、保护商业投入和维护公平竞争之间取得平衡,将成为 AI 行业持续关注的问题。