一座 AI 算力中心,并不是把 GPU 服务器放进机房就可以了。真正要让算力中心稳定运行,还需要电力、制冷、网络、存储、安全等一整套基础设施配合。
首先是算力设备,也就是 GPU 服务器,这是 AI 算力中心最核心的设备。根据业务需求,可以部署搭载 H100、H200、B200 等 GPU 的服务器,也可以采用不同数量的 GPU 组成计算节点。除了 GPU 本身,还需要 CPU、内存、GPU 高速互联设备以及高速网卡。对于大规模 AI 训练来说,多台服务器之间的数据交换速度非常重要,因此服务器通常会配置 200Gbps、400Gbps 甚至更高速率的网络接口。
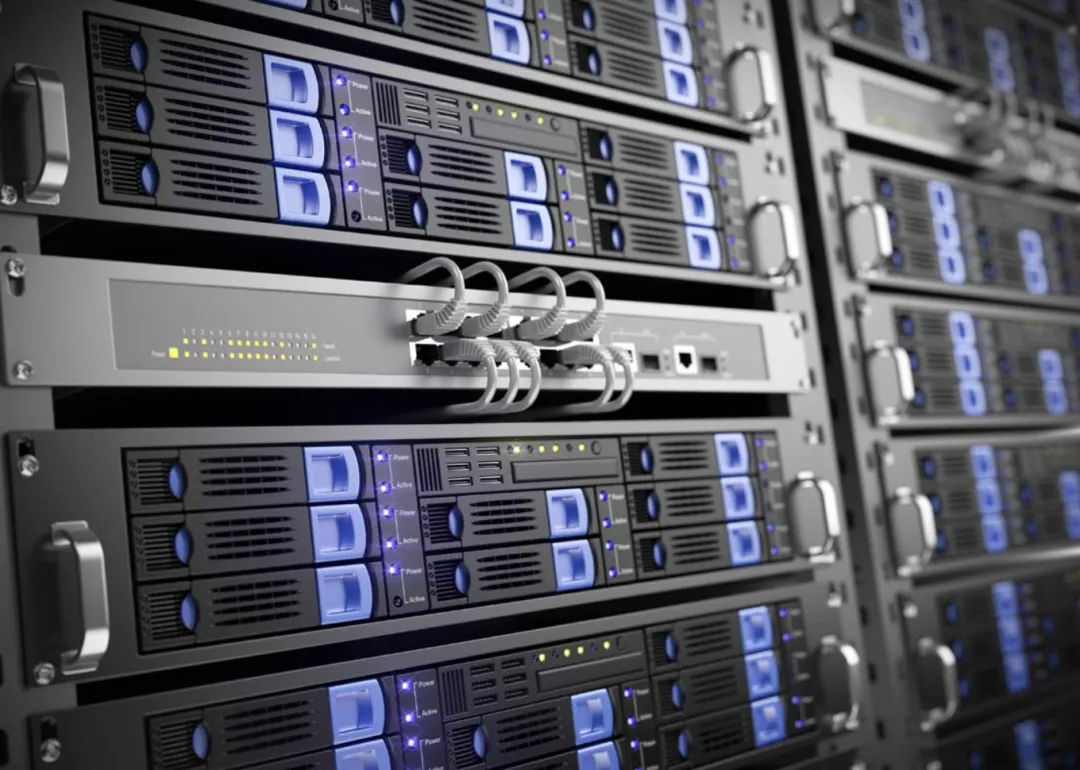
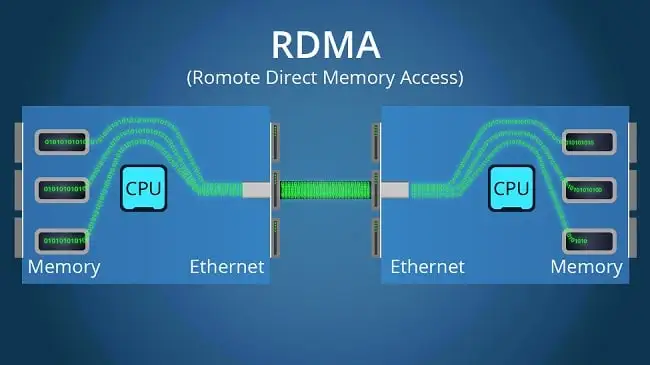
第二部分是高速网络设备。算力中心内部通常需要部署 ToR 交换机、核心交换机、路由器等设备,把大量 GPU 服务器连接起来。如果是大规模集群,还会建设专门的 AI 网络,例如采用 InfiniBand 或高速以太网,用于服务器之间的低延迟、高带宽通信。同时,算力中心还需要通过运营商专线、互联网出口或者云专线连接外部网络。
第三部分是存储系统。AI 训练会产生大量数据,包括训练数据集、模型文件、检查点以及推理结果,因此不能只依赖服务器本地硬盘。常见设备包括 NVMe SSD、高性能存储服务器、分布式存储系统以及对象存储等。对于大型 AI 集群,存储系统不仅要有足够容量,还需要提供较高的读写速度,避免 GPU 因为等待数据而降低利用率。
第四部分是供配电设备。AI 服务器功耗很高,一台高密度 GPU 服务器可能达到数千瓦,因此算力中心需要配置变压器、UPS、配电柜、PDU、柴油发电机等设备。对于规模较大的数据中心,还需要考虑双路市电、备用电源以及不同等级的供电冗余,保证设备在电网波动或者一路电源故障时仍能持续运行。
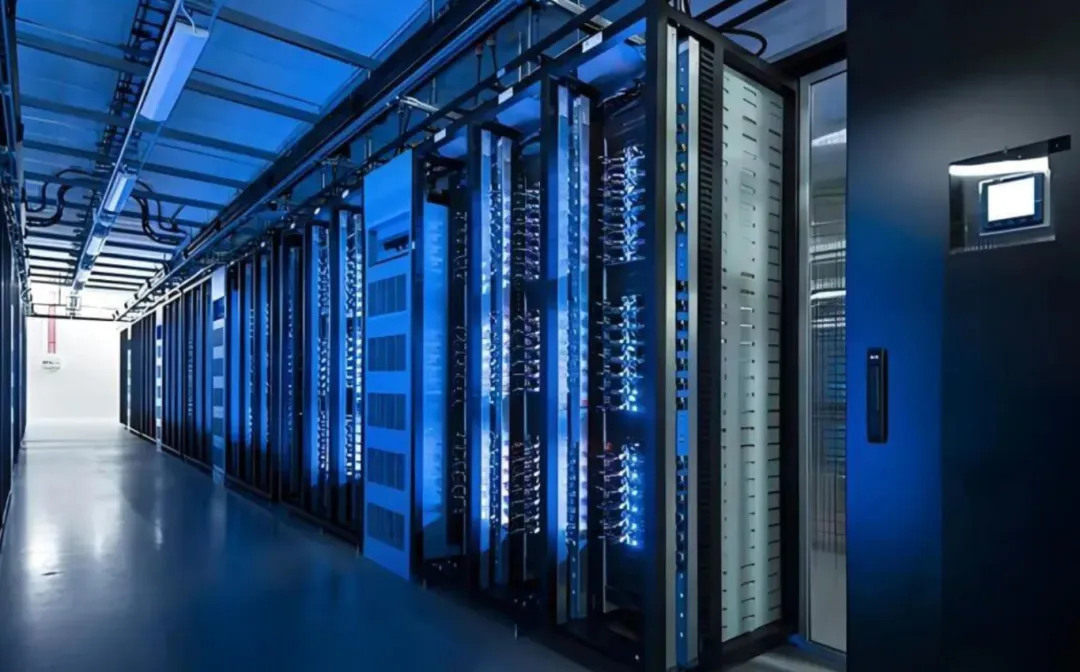
第五部分是制冷系统。传统服务器可以大量采用风冷,但高密度 GPU 集群对散热能力要求更高,因此现在很多 AI 算力中心会采用冷板式液冷、浸没式液冷或者风冷与液冷结合的方式。除了冷却设备,还需要冷源、冷却液循环系统、CDU、冷却塔等配套设施。
最后还有机房基础设施和运维系统,包括机柜、机架、消防系统、门禁、监控、环境监测,以及 DCIM 等数据中心管理系统。通过这些系统,可以实时监控服务器的温度、功耗、网络状态和设备运行情况。
所以,一座完整的 AI 算力中心,实际上可以分成算力、网络、存储、供电、制冷和机房运维六大部分。GPU 决定了算力规模,但真正决定整个算力中心能不能长期稳定运行的,是这些基础设施能否协同工作。