企业部署 AI,首先要考虑的不是选择哪款 GPU,而是业务需要多少算力、准备投入多少预算,以及后续如何使用和维护。不同的算力平台,在成本、性能、管理方式和扩展能力上都有区别,企业需要结合实际业务来选择。
目前,企业常见的算力平台主要包括公有云算力、GPU 算力租赁、独立 AI 服务器和自建算力集群。
公有云算力适合需要快速开展 AI 业务的企业。企业可以按需使用云平台提供的 GPU 实例、存储和网络资源,不需要自行采购硬件,也不必负责机房供电、散热等基础设施。对于业务规模不确定、需要短期测试模型或临时增加算力的企业,公有云部署比较灵活。不过,如果长期保持高算力使用量,还需要关注持续租用费用、数据传输费用和资源使用效率。

GPU 算力租赁适合有持续计算需求,但暂时不准备购买硬件的企业。例如,企业需要进行模型训练、微调或推理服务,可以根据模型规模、显存需求和任务量租用相应的 GPU 资源。与公有云相比,部分算力租赁服务可以提供相对固定的硬件配置和租用周期,方便企业进行成本规划。选择时需要确认 GPU 型号、显存容量、设备数量、网络带宽以及资源是否独享,避免出现配置不符合业务需求的情况。
独立 AI 服务器适合对硬件配置、运行环境和数据管理有较高要求的企业。企业可以自行采购服务器,也可以租用服务器并部署所需的软件环境。这种方式便于控制硬件配置和系统权限,但需要承担设备维护、故障处理、升级扩容等工作。如果服务器部署在 IDC 机房,还需要考虑机柜空间、供电、散热和网络接入成本。
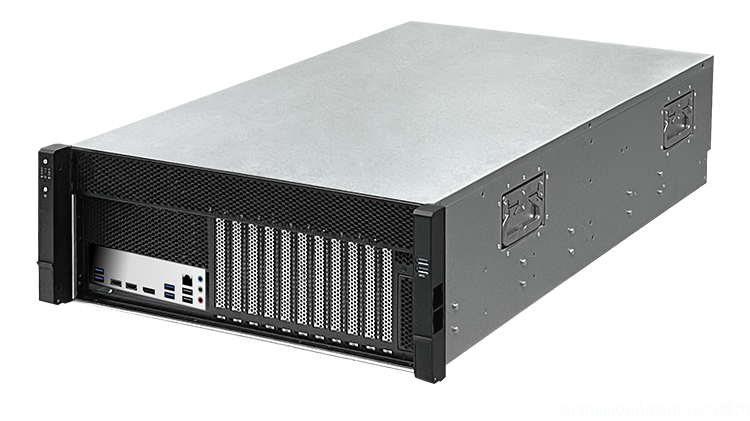
自建算力集群更适合算力需求长期稳定、业务规模较大,并且具备专业运维团队的企业。多台 GPU 服务器可以组成集群,配合高速网络、共享存储和任务调度系统,支持大规模模型训练及分布式计算。但集群建设不仅涉及 GPU 采购,还需要考虑服务器之间的网络通信、存储性能、供电能力和整体利用率,前期投入与运维要求都比较高。
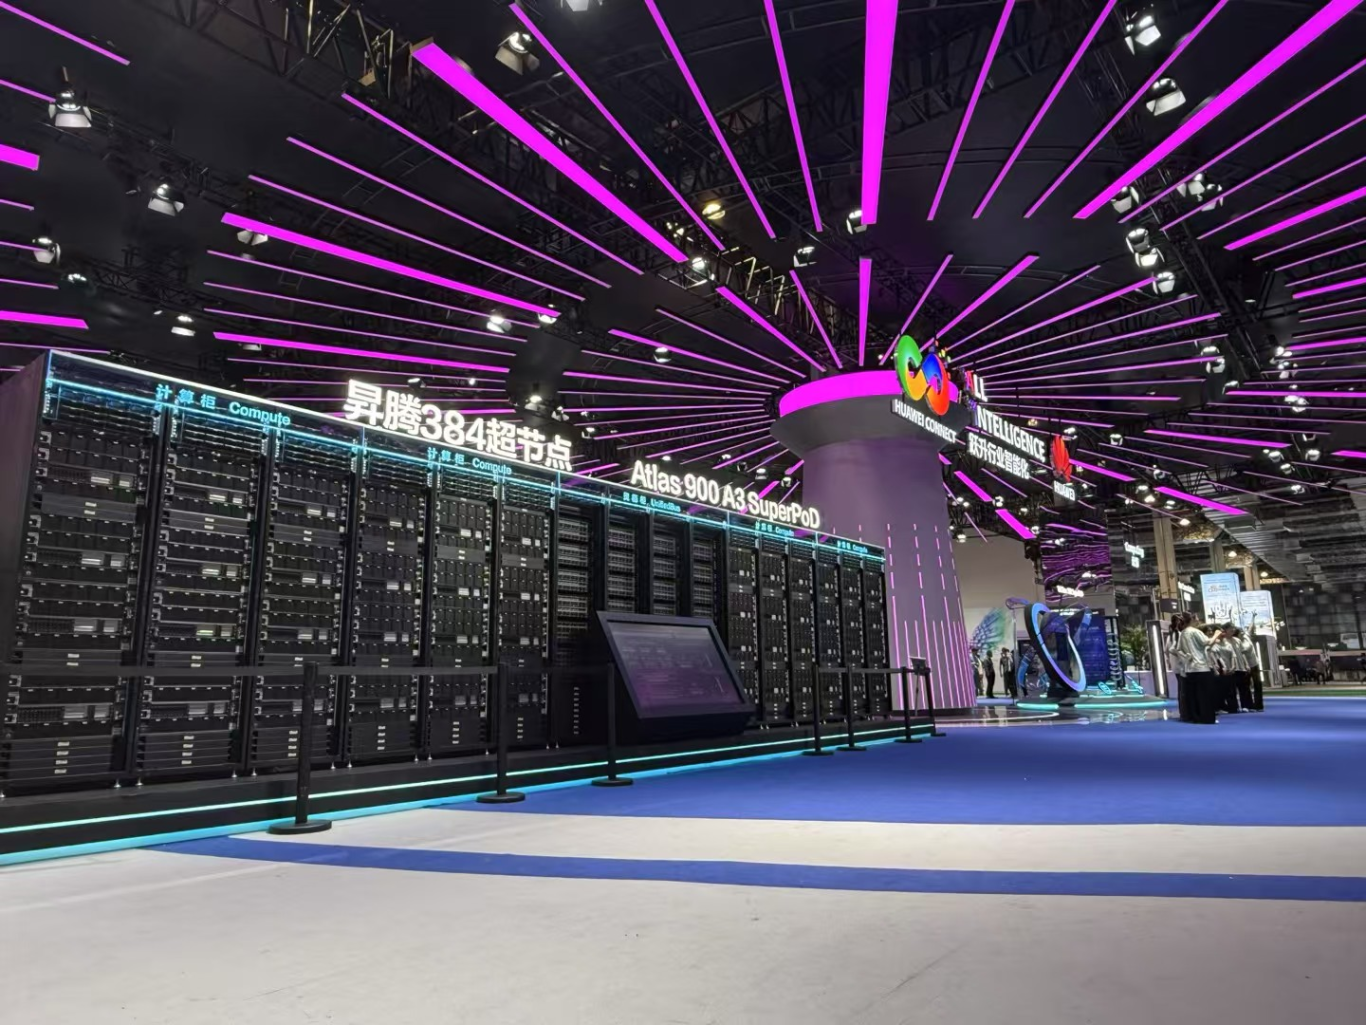
实际选择时,企业可以先明确 AI 的主要用途。如果只是验证模型或开发应用,可以优先考虑公有云;如果需要长期使用 GPU,但不想承担硬件采购成本,可以考虑算力租赁;如果对硬件控制和数据管理要求较高,可以选择独立 AI 服务器;如果需要大规模训练和持续运行多个 AI 任务,则可以进一步评估自建集群。