H20 和 H100 都是 NVIDIA 面向人工智能计算推出的数据中心 GPU,但两者在计算性能、显存配置和应用场景上存在明显区别。简单来说,H100 更侧重大规模 AI 模型训练和高性能推理,而 H20 则更加注重显存容量、推理效率以及特定市场的部署需求。
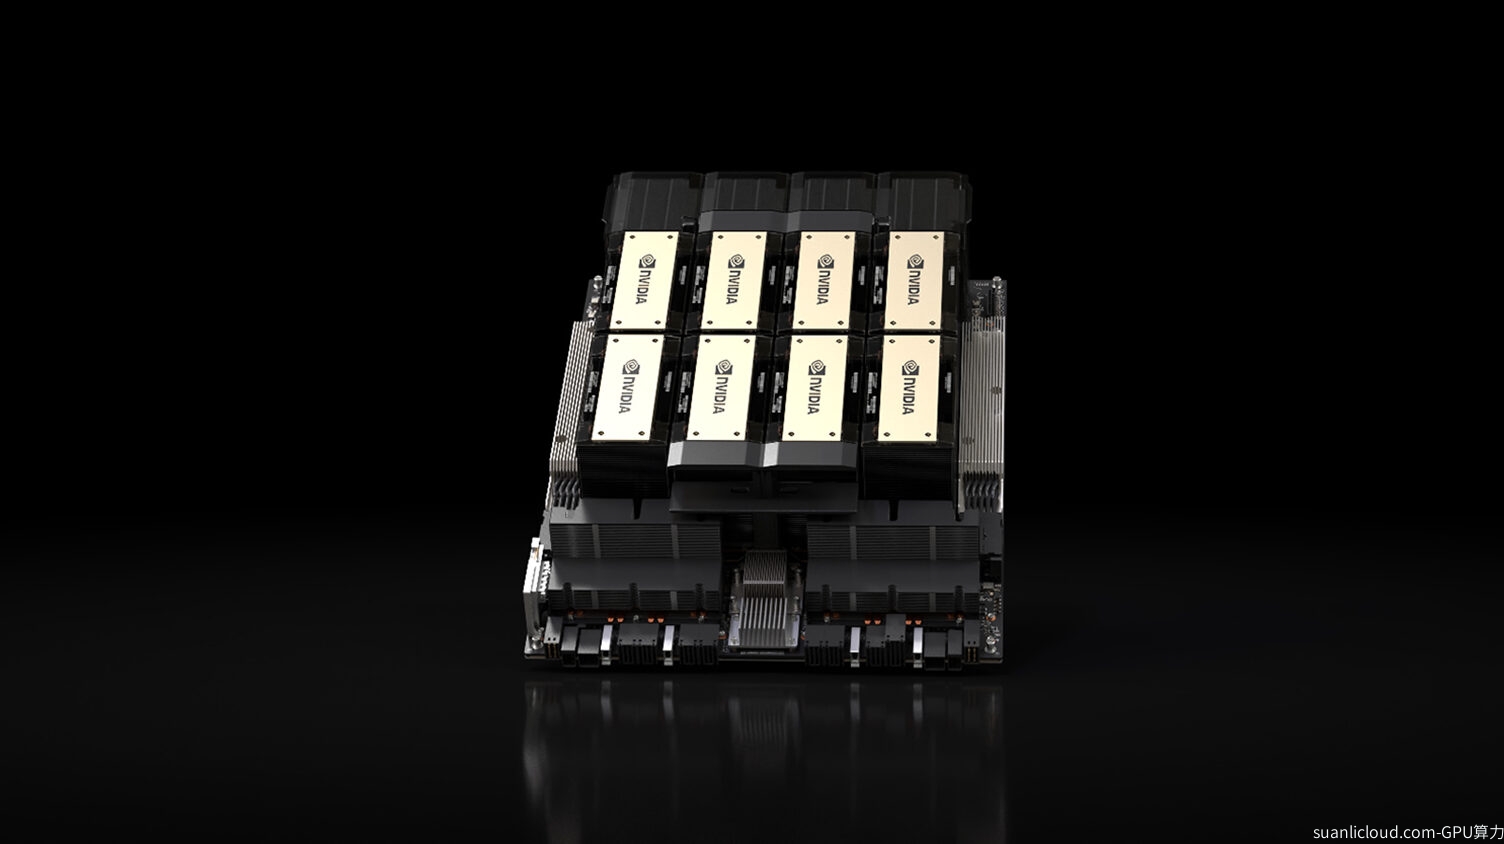
H20
H100 是 NVIDIA Hopper 架构的代表性 GPU,主要面向大型语言模型训练、深度学习和高性能计算等场景。它采用 HBM3 高带宽显存,显存容量为 80GB,显存带宽约为 3.35TB/s,能够提供较强的 FP16、BF16 和 FP8 等低精度计算能力。在大规模 AI 模型训练过程中,H100 可以利用较高的计算性能和显存带宽,加快模型训练、参数更新以及数据处理速度。目前,H100 也是大型 AI 训练集群中比较常见的 GPU 产品。
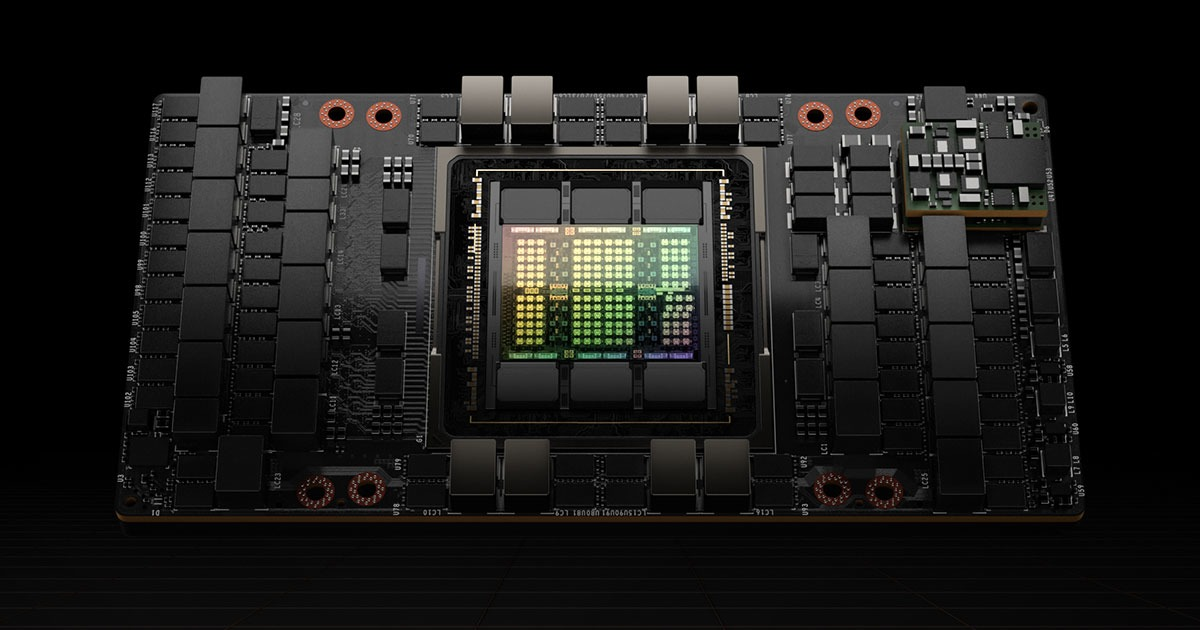
H20 同样基于 NVIDIA Hopper 架构,但它的产品设计重点与 H100 不同。H20 面向特定市场的出口管制要求进行了性能配置调整,在部分计算能力方面有所限制,但保留了较大的显存容量和较高的显存带宽。H20 配备 96GB HBM3 显存,显存带宽约为 4TB/s,容量和带宽均高于标准版 H100 80GB。对于大型语言模型推理业务来说,较大的显存可以容纳更多模型参数和 KV Cache 数据,减少模型切分到多张 GPU 上运行的需求,有利于提高单卡部署能力。
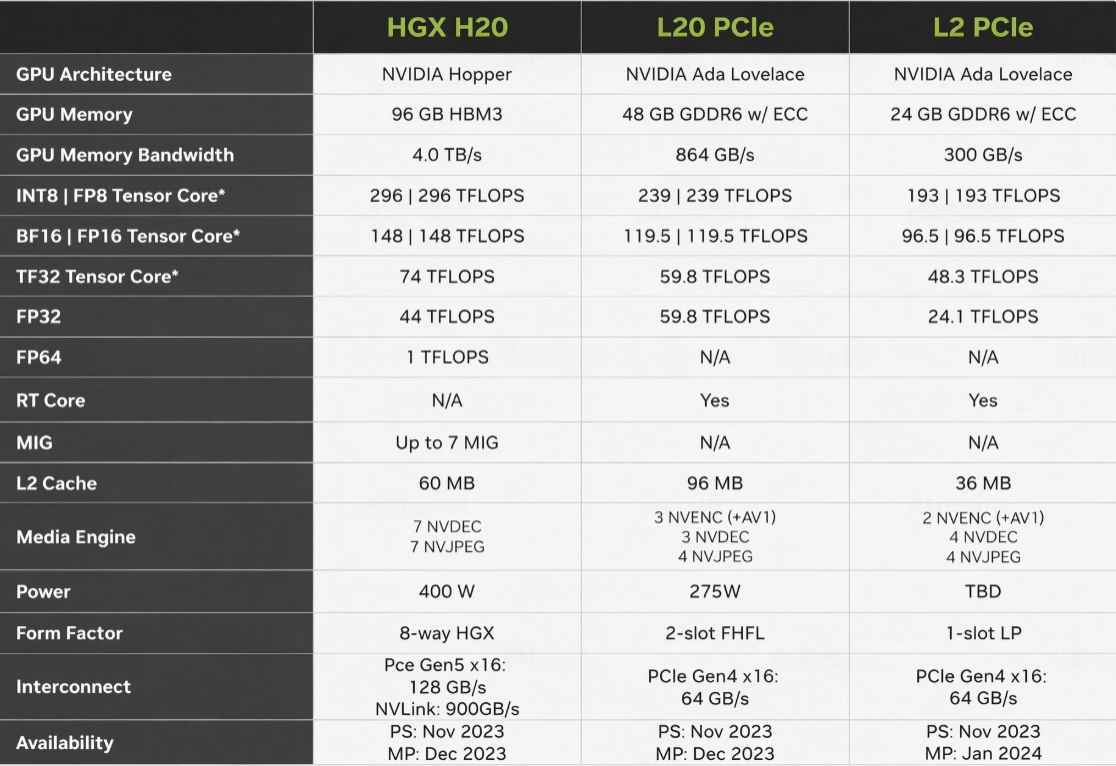
从实际应用来看,H100 更适合对计算性能要求较高的模型训练、大规模 AI 集群以及复杂推理任务;H20 则更适合显存需求较大、计算强度相对适中的 AI 推理业务。当然,具体表现还要结合模型规模、精度、批处理大小以及软件优化情况进行判断。
总体来说,H20 并不是 H100 的简单升级版本,两者的设计侧重点不同。H100 更强调计算能力,而 H20 更注重显存容量与推理部署需求。企业在采购 GPU 服务器时,不能只看显存大小,还需要结合模型训练还是推理、实际算力需求、服务器配置和整体部署成本进行选择。