2023 年以来,英伟达的数据中心 GPU 成了 AI 时代的"硬通货"。但 H100、H200、B200 这三款名字相近的旗舰,差别究竟在哪?它们并非"数字越大越强",而是分属不同架构世代。
H100:Hopper 架构的开山之作
H100 于 2022 年底随 Hopper 架构发布,是这一轮大模型浪潮的主力。它搭载 80GB HBM3 显存,带宽 3.35 TB/s,FP8 算力约 1979 TFLOPS(稀疏),整卡功耗 700W。凭借 Transformer Engine 与 FP8,H100 性价比至今仍是标杆,软件生态也最成熟。
但它受限于 80GB 显存,跑 70B 级大模型时常需多卡并行。
H200:同源换"大显存"的升级款
H200 与 H100 使用同一颗 GH100 核心,算力完全一致,真正的改变在显存:容量提升到 141GB HBM3e,带宽跃升至 4.8 TB/s,比 H100 多出约 76% 的容量与 43% 的带宽,功耗却仍是 700W。对长上下文、RAG、高并发推理这类"显存饥渴"的场景,一张 H200 可顶两张 H100。
换言之,它是为"装得下"而生,而不是为"算得快"而生——算力相同,只是把"油箱"换大了。
B200:Blackwell 架构的代际跨越
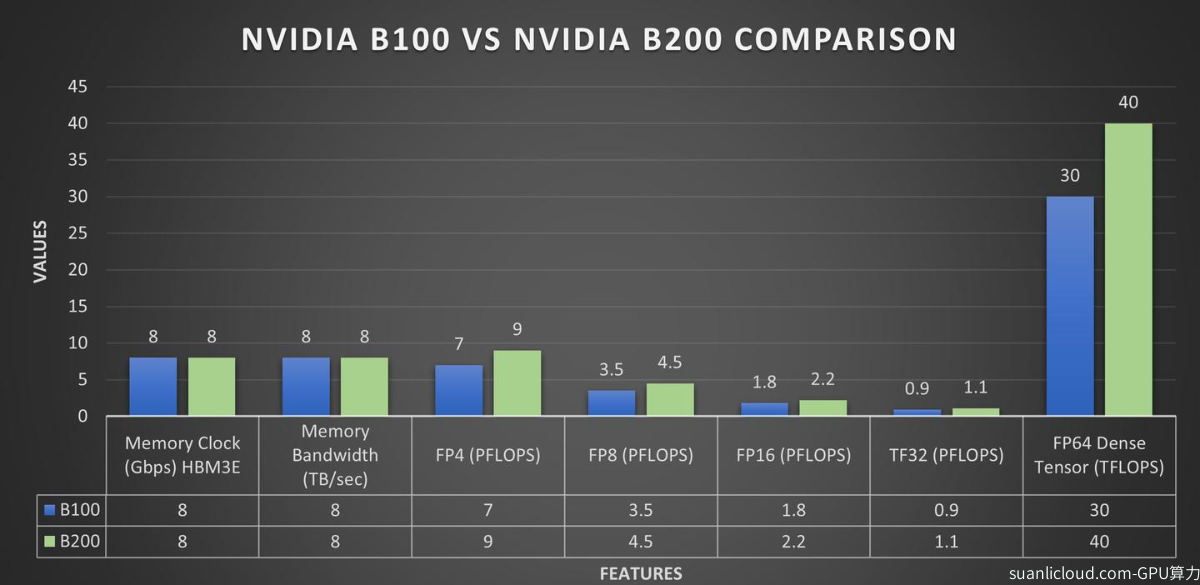
B200 属于全新的 Blackwell 架构,双 die 设计,集成 2080 亿晶体管。显存达到 192GB HBM3e,带宽高达 8 TB/s,FP8 算力约 4500 TFLOPS,并首次原生支持 FP4 精度(约 9000 TFLOPS),NVLink 带宽翻倍至 1.8 TB/s,但功耗也升到 1000W。
相比 H100,B200 在 FP8 推理上约有 2.5 倍提升,开启 FP4 后差距进一步拉大,是训练万亿参数超大模型的主力。
| 规格 | H100 SXM | H200 SXM | B200 |
|---|---|---|---|
| 架构 | Hopper | Blackwell | |
| 显存 | 80GB HBM3 | 192GB HBM3e | |
| 显存带宽 | 3.35 TB/s | 8.0 TB/s | |
| FP8 算力 | ≈1979 TFLOPS | ≈4500 TFLOPS | |
| FP4 支持 | 不支持 | 原生支持 | |
| 功耗 (TDP) | 700W | 1000W | |
| NVLink 带宽 | 900 GB/s | 1.8 TB/s |