B300 是英伟达 Blackwell Ultra 架构下的重要 GPU 产品,主要面向大规模 AI 模型训练和推理。它并不是一次全新的 GPU 架构换代,而是在 Blackwell 架构基础上,对计算性能、显存容量、显存带宽以及数据传输能力进行了进一步升级,因此被称为 Blackwell Ultra。
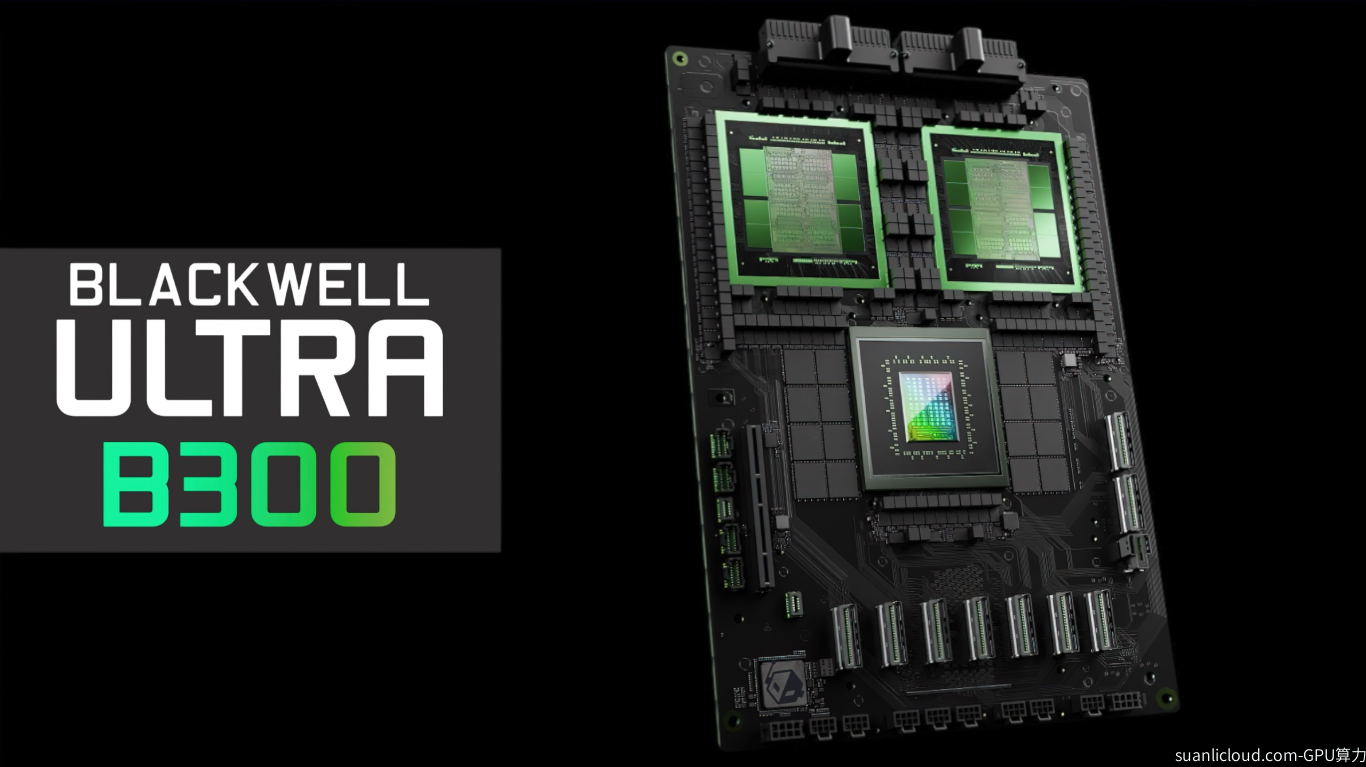
首先,B300 名称中的 Ultra,代表的是 Blackwell 架构的增强版本。它延续了 Blackwell 的核心设计,但在 GPU 芯片、HBM 显存和整机计算能力方面进行了强化。与上一代 B200 相比,B300 的重点升级之一就是显存容量。
在显存方面,B300 配备了 288GB HBM3E 显存,而 B200 为 192GB,容量提升了 50%。这意味着 GPU 可以在显存中容纳更多模型参数、KV Cache 和中间计算数据,减少模型运行过程中频繁调用外部存储或进行数据交换的情况。对于超大规模语言模型和长上下文推理任务来说,更大的显存容量能够提供更大的运行空间。
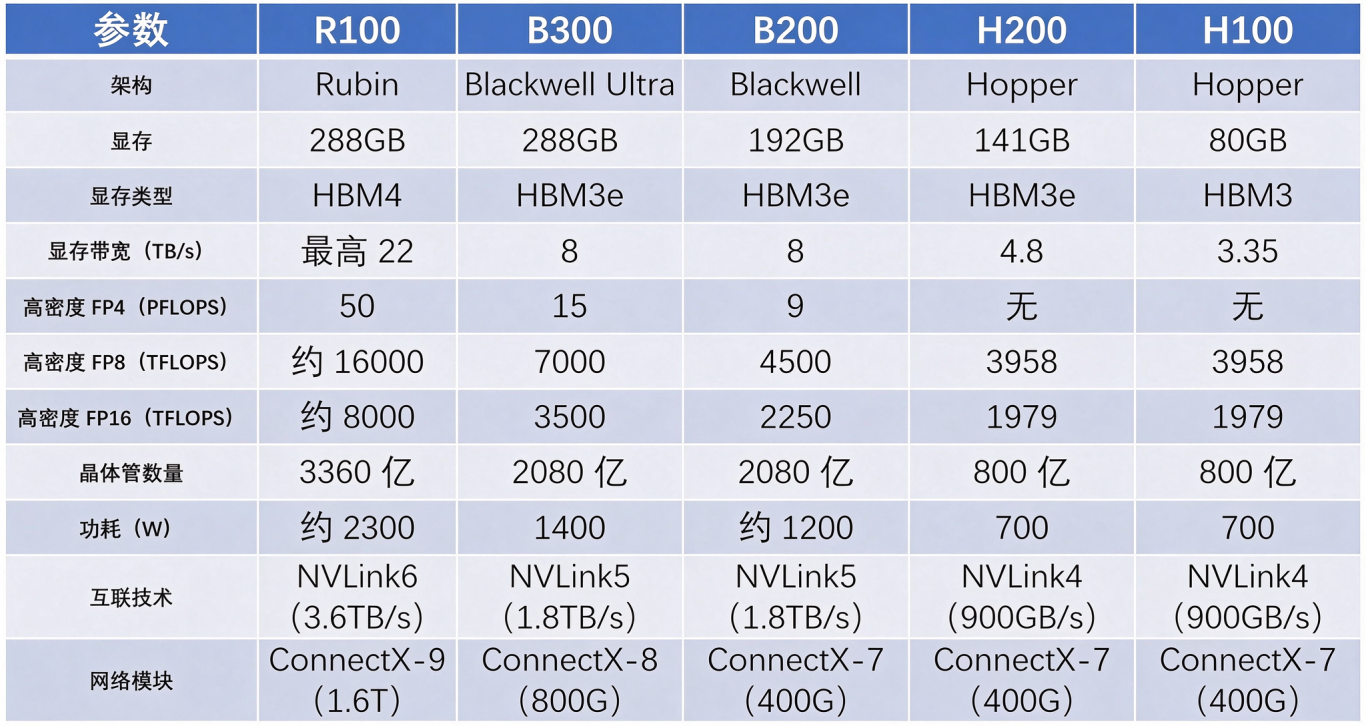
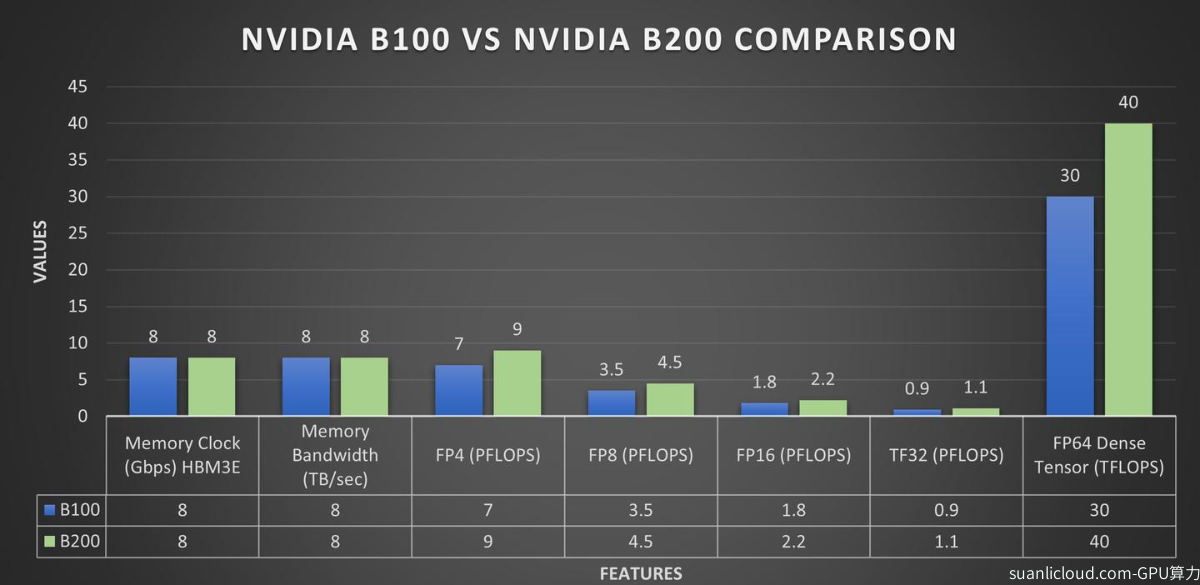
其次,B300 提升了 GPU 的计算性能。它采用 Blackwell Ultra GPU 设计,进一步增强了面向 AI 工作负载的低精度计算能力,尤其是 FP4 等低精度数据格式。FP4 可以在保证一定模型精度的前提下,降低计算和显存占用,提高 AI 推理效率。不过,实际性能还会受到模型结构、量化方式和软件优化的影响。
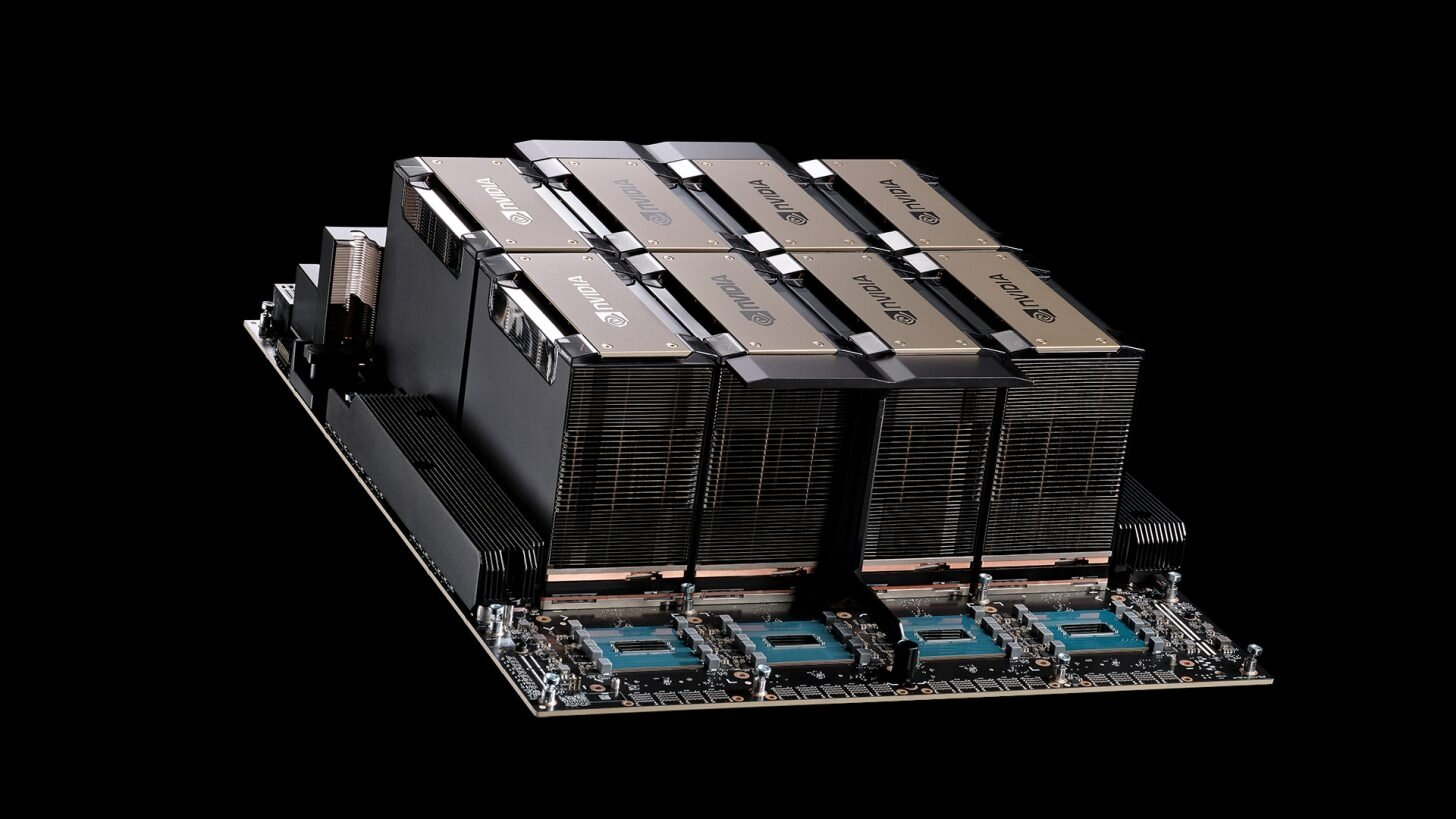
另外,B300 对注意力计算单元也进行了升级。英伟达表示,Blackwell Ultra 的注意力计算性能相比上一代 Blackwell 提升约 2 倍。这项升级对长上下文模型尤其重要,因为模型处理的文本越长,注意力计算所需要处理的数据就越多,提升这部分性能能够改善长文本推理的效率。
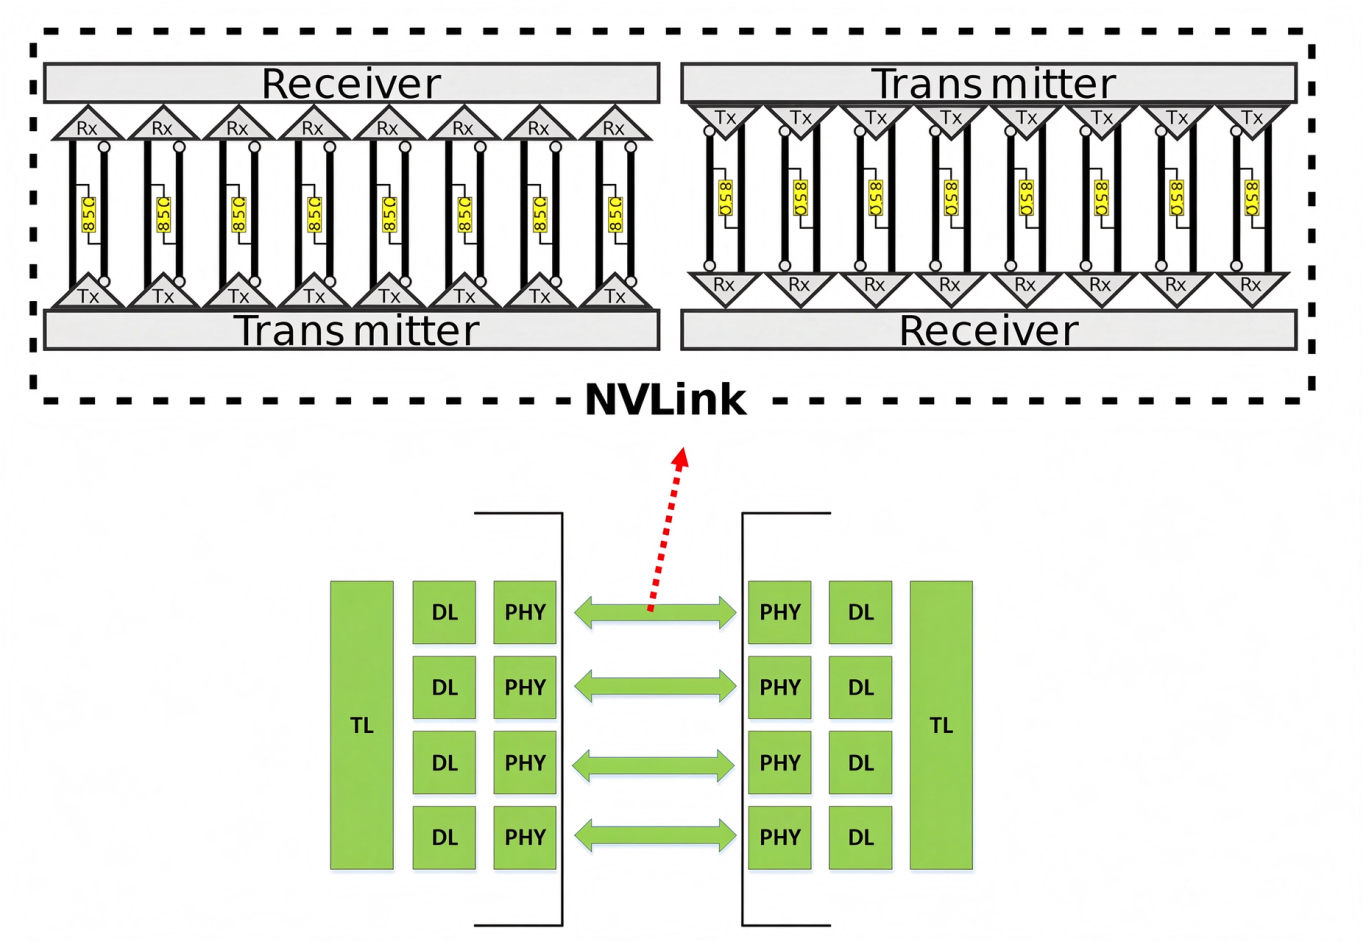
在芯片内部设计上,B300 仍然采用双芯片设计,通过 NV-HBI 高速互连接口连接两个计算芯片,保持统一的 GPU 计算环境。在 GPU 之间的数据传输方面,它继续采用第五代 NVLink,单 GPU 双向带宽最高达到 1.8TB/s,并没有因为 Ultra 名称而更换全新的 NVLink 标准。
需要注意的是,B300 还强化了整机网络能力。配套的 GB300 系统引入 ConnectX-8 网卡,网络连接速率最高可达 800Gbps,能够满足多台 GPU 服务器之间的大规模数据交换需求。
总体来看,B300 被称为 Blackwell Ultra,主要是因为它在 Blackwell 原有架构上,进一步提升了显存容量、AI 计算性能和注意力计算能力。其中,显存扩容和 FP4 计算性能提升,对大模型推理的帮助尤其明显。它更适合超大规模模型部署、长上下文推理以及 AI Agent 等计算密集型任务。
技术说明:不同 B300 产品规格存在差异。英伟达资料中,Blackwell Ultra GPU 的最高显存规格为 288GB,而 HGX B300 对应规格为 270GB,具体以整机配置为准。
参考资料: NVIDIA Blackwell Ultra 芯片技术解析、NVIDIA Blackwell Ultra 官方规格书