一句话答案:它不是某一样东西费电,而是"算得猛、散热狠、供电还有损耗"三件事叠在了一起。传统服务器大部分时间在摸鱼,AI 服务器是焊死了油门一路踩到底。
01芯片自己就越来越能吃
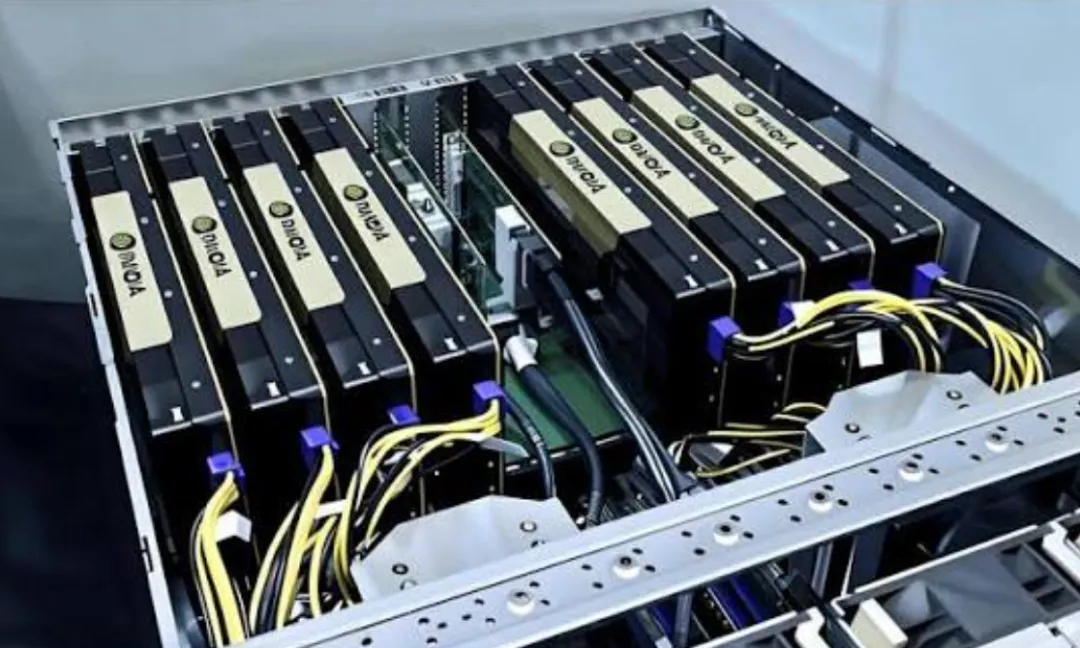
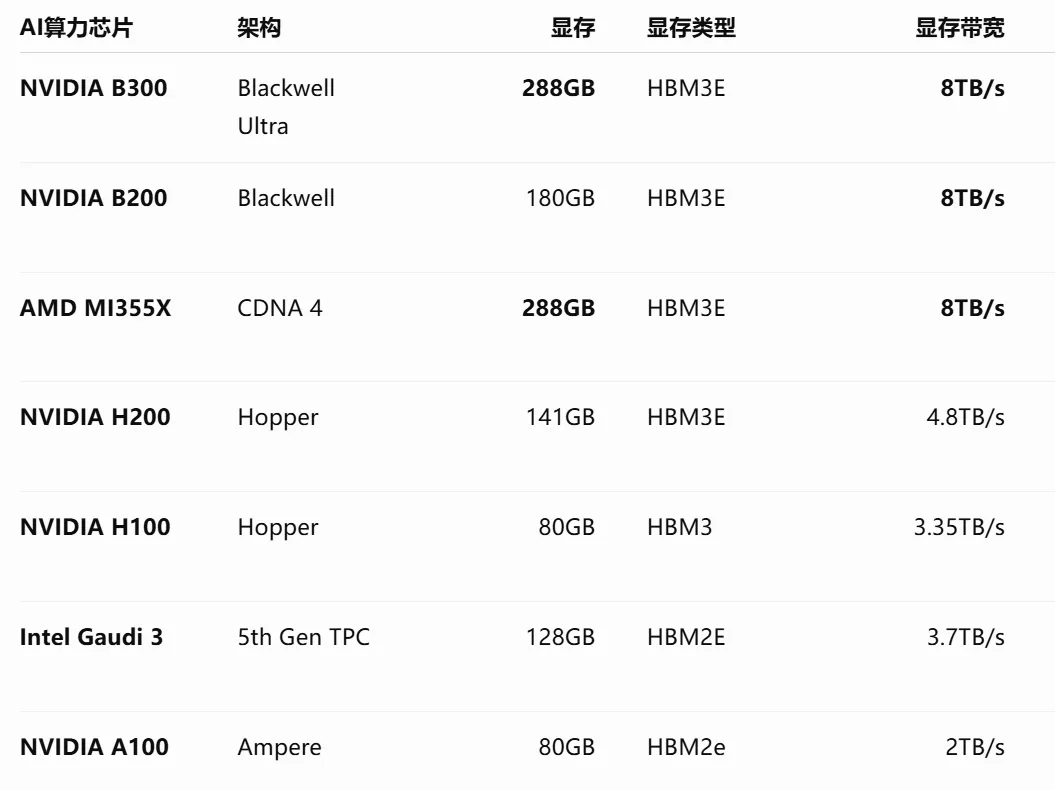
先看单卡。英伟达 A100 是 400W,到了 H100 跳到 700W,最新的 B200 直接 1000W——一代差不多翻倍。一台装 8 张 H100 的服务器满负荷就要 10kW 出头,而普通托管机房一个机柜才给 5–10kW。也就是说,一台 AI 服务器,就顶得上别人一整柜。
02它从不"休息",利用率拉满
普通电脑大部分时间在待机、刷网页,CPU 闲着。AI 训练是海量矩阵乘法,GPU 天生就是要被"喂饱"的——一旦开训,利用率常年贴在 90% 以上,电费自然按满功率走。推理服务更狠,7×24 小时持续跑,根本不给电费喘口气的空隙。
03散热是隐形电老虎
GPU 跑起来结温能到 83°C,为保护芯片它会自动降频——有案例换了液冷后温度降到 44°C,同样负载性能直接高 30%。问题就在这:风冷把热带走的效率有天花板,PUE(总电÷IT 设备电)普遍在 1.5–1.8;换成液冷能压到 1.1 左右。等于你算 1 度,风冷时代有将近 0.6 度花在吹风和空调上。
液冷从"可选项"变成 AI 机房的必选项
04网络和供电也在悄悄吃电
还有两块容易被忽略。一是互联:大规模训练要靠几千台 InfiniBand 交换机组网,单台就 1.2–1.5kW,全集群加起来能烧掉几兆瓦。二是供电本身:为保证 7×24 不停机,电源普遍做 N+N 冗余,再加上 PDU、转换损耗,又是一层"电费税"。
把这些叠起来就有数了:英伟达 GB200 NVL72 整机柜塞 72 张 GPU,单柜 120kW,相当于 12–25 个普通机柜的用电量。所以 AI 服务器费电,不是设计偷懒,是算力、散热、供电三笔账一起爆了——而限电的,往往不是 GPU,是机柜后面那根电线。