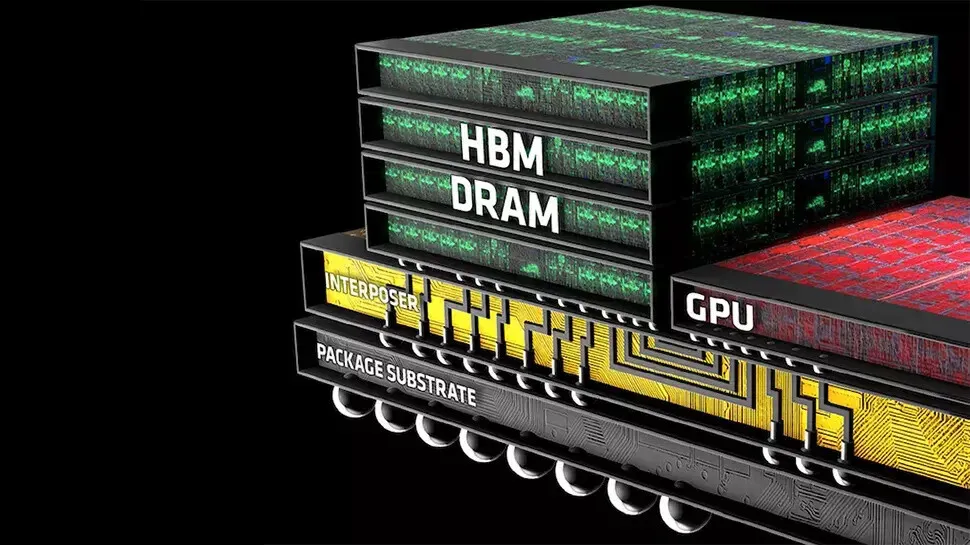
GPU算力中心之间传输的,并不只是普通文件。真正占用大量网络带宽的,主要是训练数据、模型参数、梯度、Checkpoint,以及任务调度和存储访问产生的数据。
首先是训练数据。AI模型训练需要大量文本、图片、视频、语音等数据。如果数据没有全部放在GPU服务器本地,而是存储在其他算力中心、IDC机房或者集中式存储系统中,GPU集群就需要通过高速网络持续读取这些数据。数据量越大,对网络带宽的要求就越高。
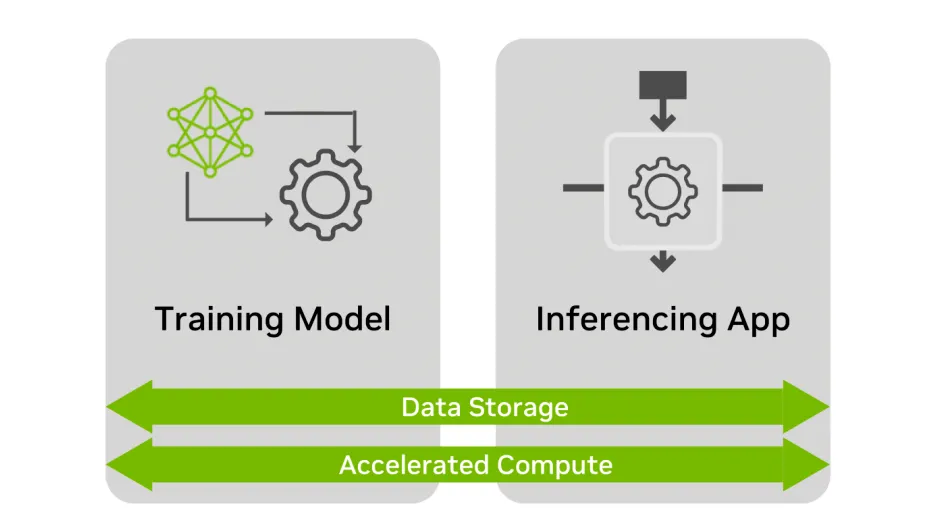
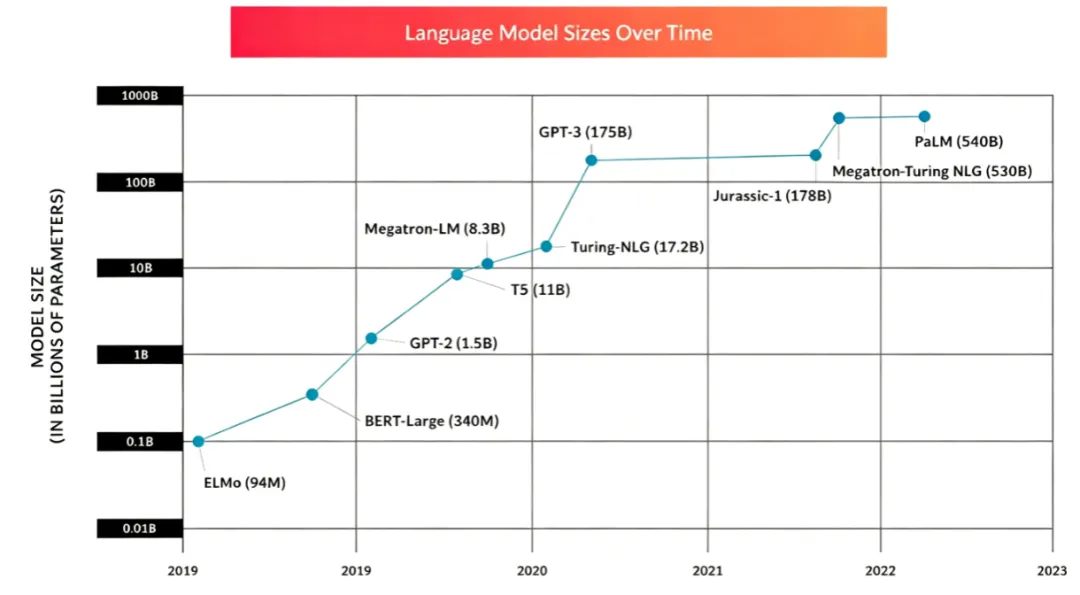
第二类是模型参数和梯度。这是GPU算力中心之间最重要的一类数据。在分布式训练中,一套模型通常会被部署到多台服务器甚至多个算力集群上。每张GPU完成计算后,需要把梯度、参数更新等信息同步给其他GPU。特别是大模型训练,参数规模非常大,GPU之间需要频繁进行通信。如果网络带宽不足或者延迟、丢包比较严重,GPU就可能出现等待通信的情况,整体训练效率会明显下降。
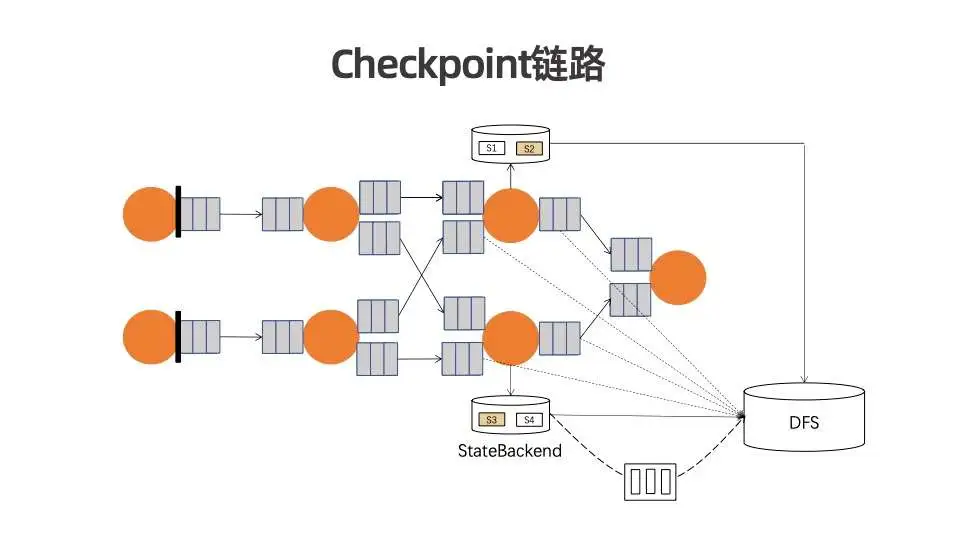
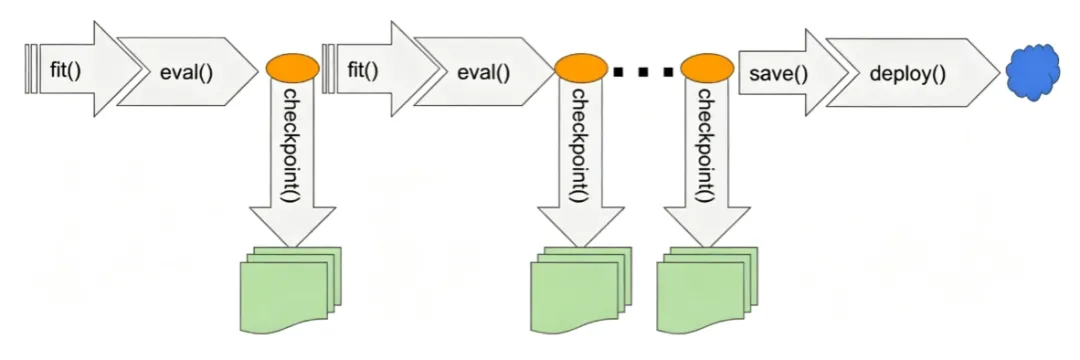
第三类是Checkpoint和模型文件。训练一个大型模型通常需要持续保存Checkpoint,用于故障恢复和训练进度管理。如果算力中心之间需要进行异地备份、模型迁移或者训练任务接续,就需要传输大量模型文件。一个Checkpoint可能就是几十GB甚至几百GB,因此这类业务对持续带宽要求比较高。
除此之外,还有数据集同步、容器镜像、软件包、日志、监控数据以及任务调度信息。这些数据单独来看可能没有那么大,但在大型算力集群中会产生大量并发连接。
所以,GPU算力中心之间的网络,关注的不只是“带宽有多大”。还要重点看时延、丢包率、抖动、链路稳定性以及东西向流量能力。例如单台GPU服务器可能使用100G、200G甚至400G网络,多台服务器组成集群后,算力中心内部和不同算力中心之间都会形成非常大的数据交换需求。
这也是为什么AI算力中心越来越重视高速网络、RDMA、RoCE、400G/800G网络以及DCI互联。GPU性能不断提升之后,如果网络无法及时完成数据交换,就很容易出现算力资源利用率下降的问题。
简单来说,GPU算力中心之间传输的核心数据,就是数据集、模型参数、梯度、Checkpoint和业务运行数据。而随着大模型规模持续扩大,算力中心之间的网络也正在从传统的数据传输网络,逐渐向高带宽、低时延、高可靠的计算网络方向发展。