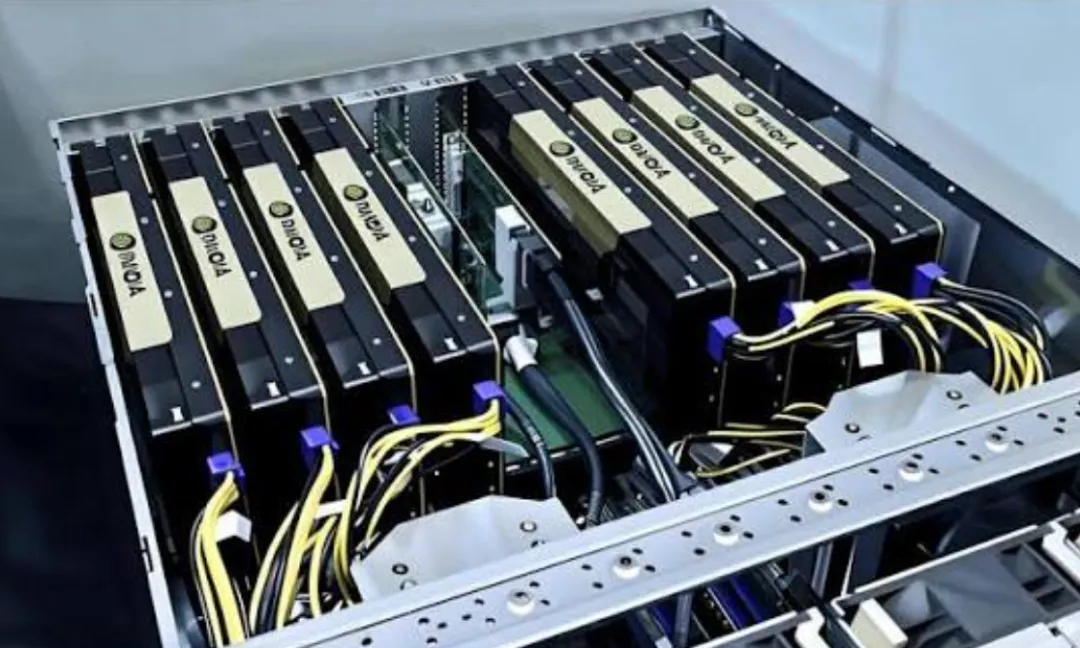
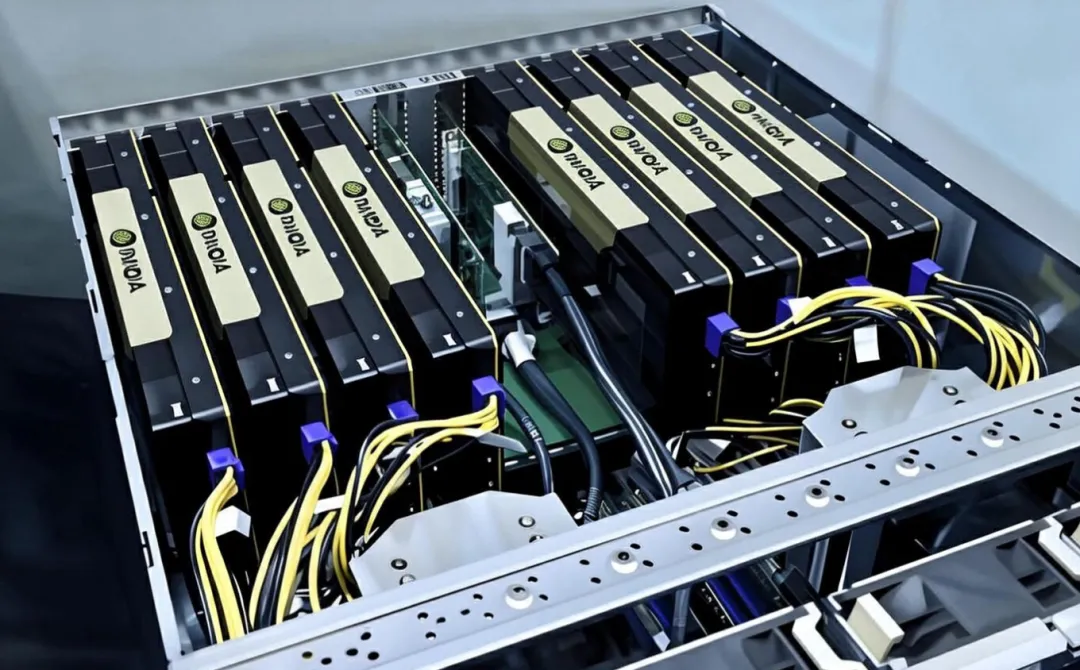
答案是可以!前提是解决好芯片之间的通信、软件兼容和任务调度问题。现在 AI 算力需求不断增长,越来越多企业希望在同一个数据中心内使用不同厂商的 AI 芯片,以满足不同业务的计算需求,同时降低对单一供应商的依赖。
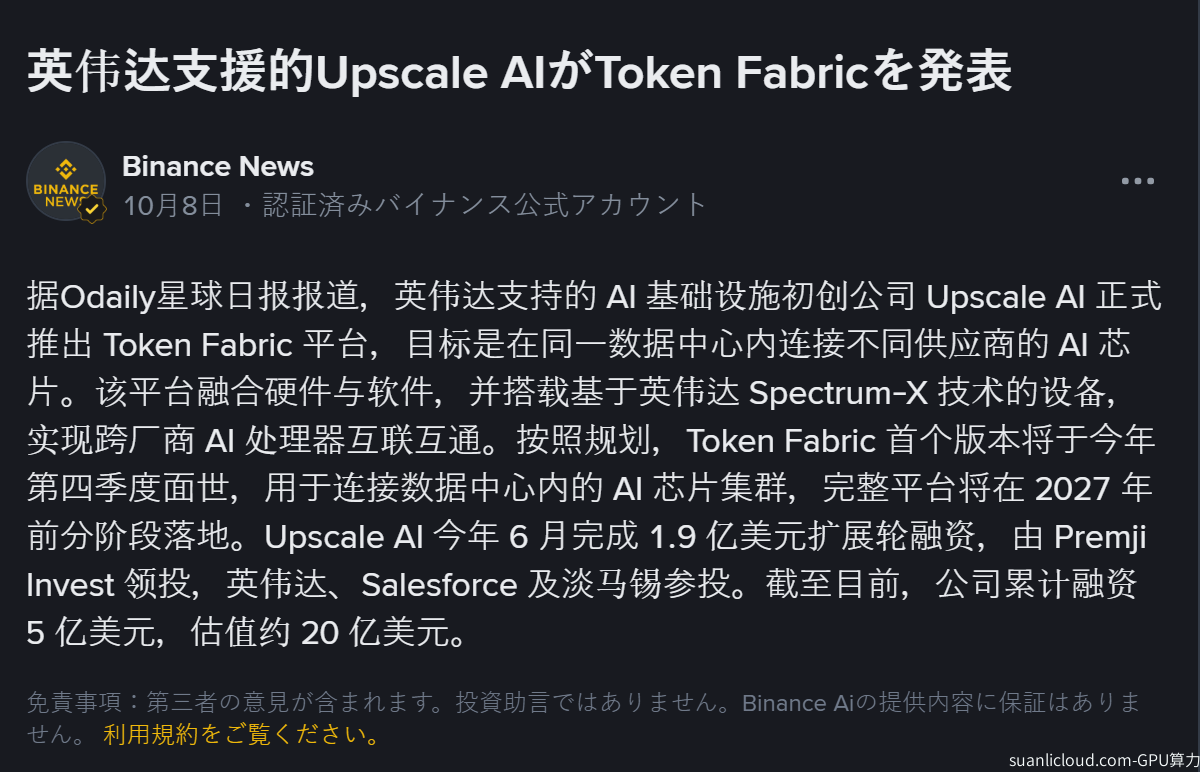
10月8日,AI基础设施企业 Upscale AI 推出了 Token Fabric 平台,目标就是帮助数据中心连接不同供应商的 AI 处理器。该平台将网络硬件与软件管理结合起来,希望减少多种 AI 芯片共同部署时的网络整合难度。
那么,不同厂商的 AI 芯片为什么不能直接连接使用?
首先,不同芯片的硬件架构和软件生态存在差异。例如,英伟达 GPU、AMD GPU,以及其他厂商研发的 AI 加速芯片,在计算架构、驱动程序、开发工具和通信机制方面可能并不相同。即使它们都能执行 AI 计算,也不代表它们可以直接组成一个高效协同的计算集群。企业需要根据芯片支持的通信协议、软件框架和任务类型,完成适配与配置。
其次,芯片之间的数据传输同样重要。AI 模型训练和推理通常需要多个加速器交换数据,涉及参数、计算结果和中间数据等内容。如果网络带宽不足、延迟过高,或者通信机制无法有效配合,就可能影响整体计算效率。因此,AI 算力中心不仅要关注芯片本身的性能,还需要建设能够满足高带宽、低延迟需求的网络系统。
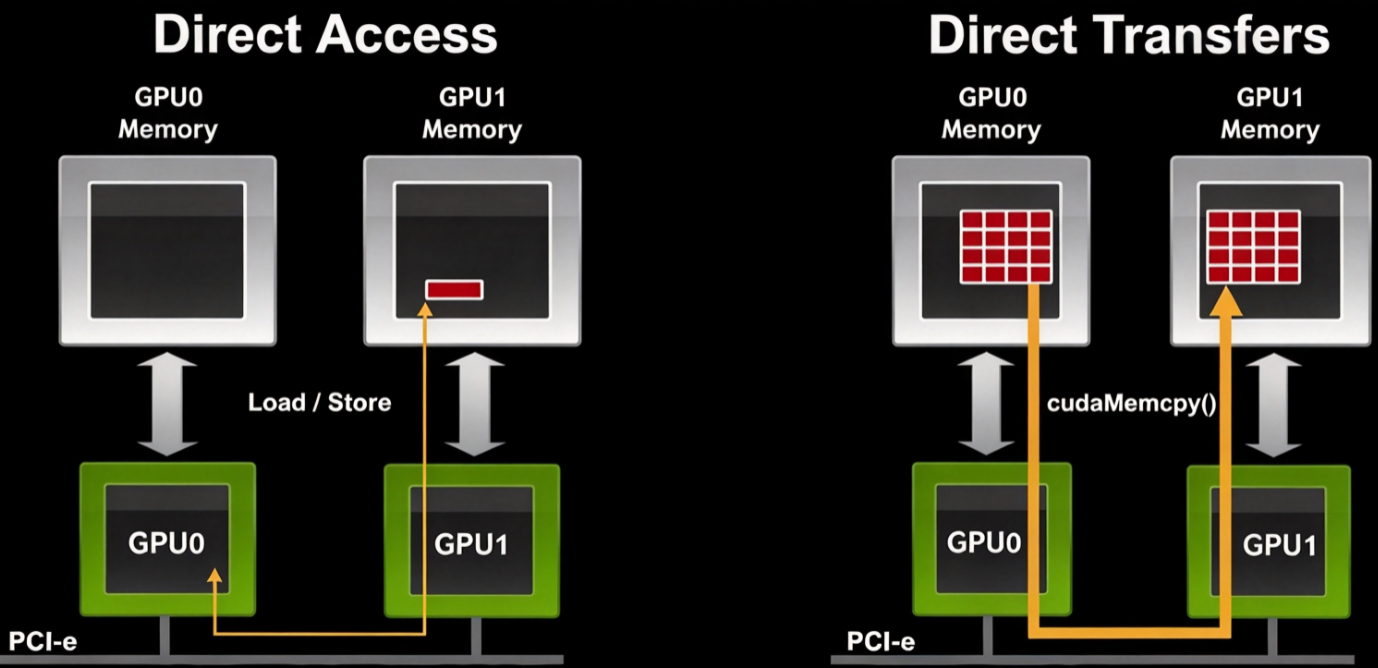
在网络架构上,通常需要考虑两个层面:一是机架内部或紧密连接的加速器之间如何通信,二是不同服务器、机架之间如何进行数据传输。前者通常称为纵向扩展,后者称为横向扩展。两者需要共同配合,才能支持大规模 AI 任务运行。
Upscale AI 推出的 Token Fabric,正是围绕这些问题展开。它整合交换芯片、网络设备和软件管理能力,尝试通过开放标准连接不同类型的 AI 加速器,并统一管理数据中心内的网络资源。需要注意的是,网络互通并不意味着所有芯片都能直接混合执行同一个模型任务,具体还取决于软件适配、计算框架和任务调度能力。
对企业来说,未来建设 AI 算力中心,选择芯片时不能只比较算力、显存和价格,还要考虑网络兼容性、软件生态、扩展能力以及运维成本。不同厂商的 AI 芯片可以部署在同一个算力中心,但要真正实现高效协同,仍然需要完善的网络架构、软件适配和统一调度系统。