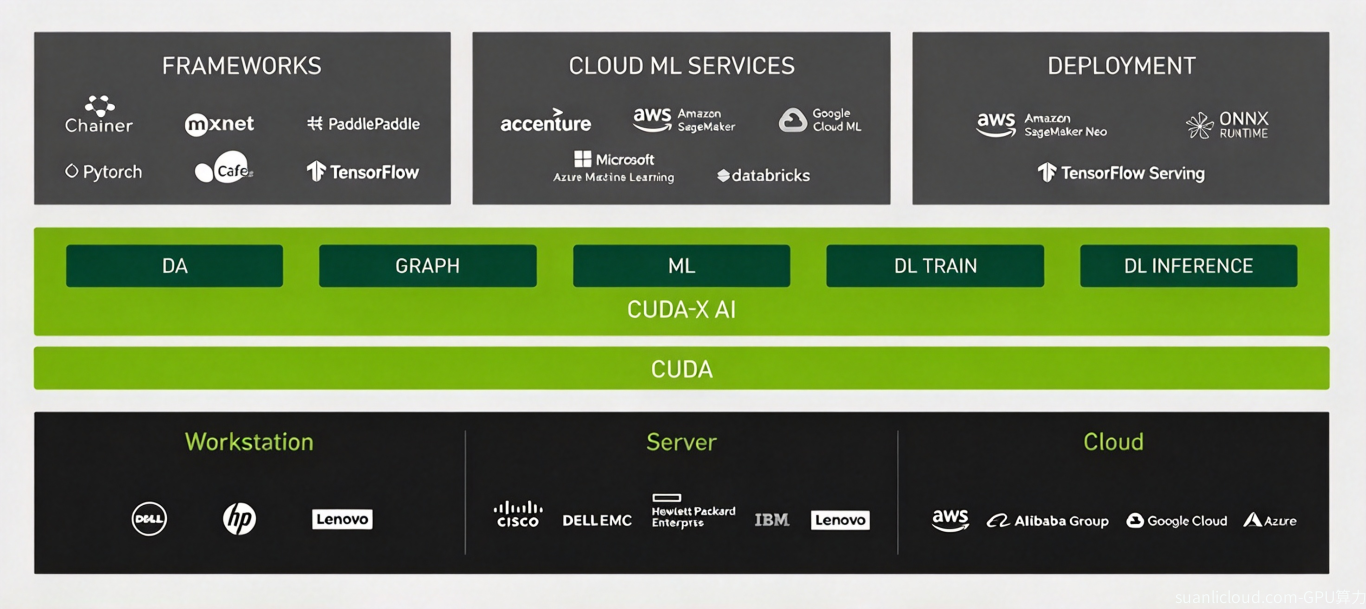
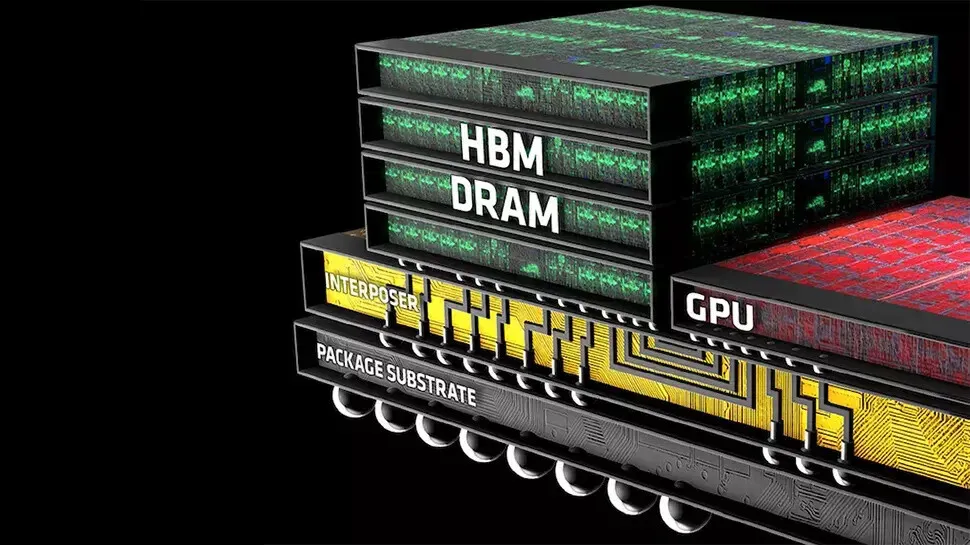
AI浪潮之下,算力已成为企业的核心生产力。面对模型训练与推理需求,技术负责人常陷入两难:是一次性采购GPU服务器,还是直接租用云上GPU算力?答案并不绝对,关键要看利用率、资金状况与业务节奏。
自建算力示意:企业数据中心机房
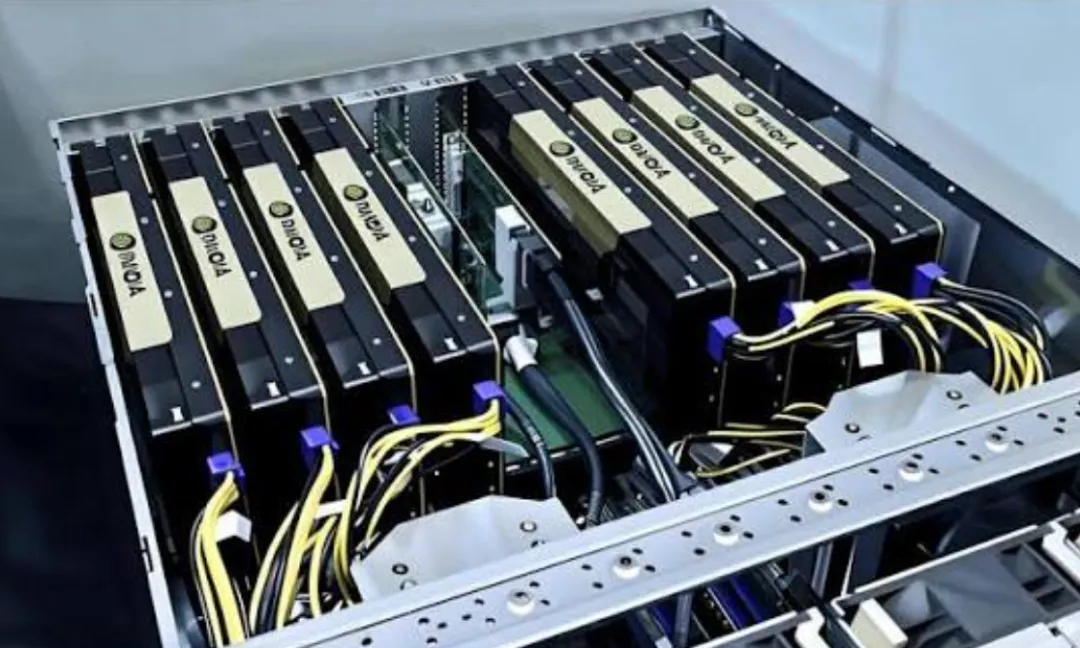
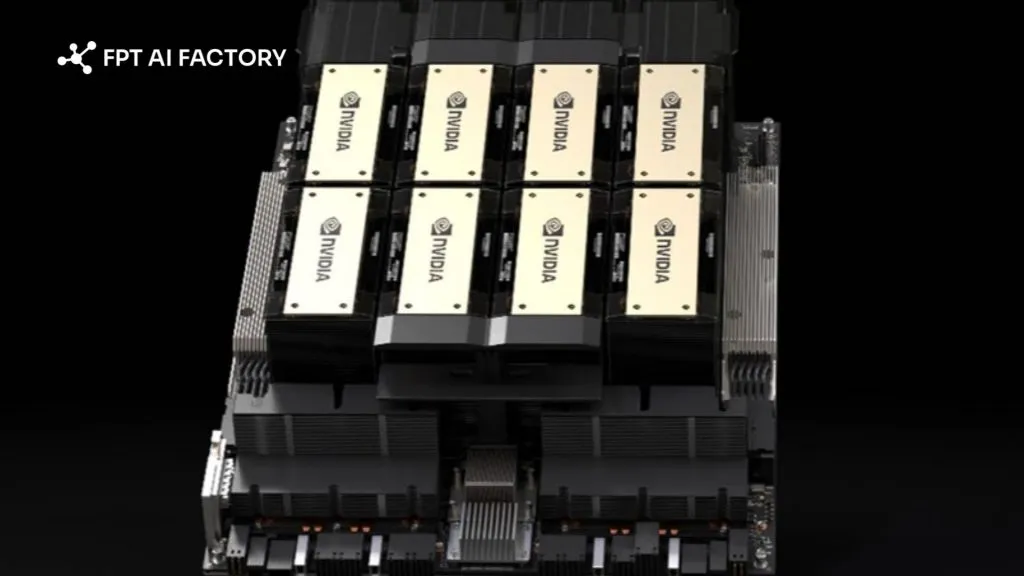
先看"买"。自建算力属于重资产投入。以8张A100显卡为例,硬件加上服务器、机房、散热与运维,一次性支出常超百万元,三年总拥有成本(TCO)可达两百万元以上。它的优势在于数据始终留在企业内网,满足强合规与数据主权要求;内网延迟极低,性能稳定可预期;当全年利用率持续高于75%时,长期摊薄后单位成本反而更低。但代价同样明显:硬件升级周期长、扩容需数月、要养一支专业运维团队,而GPU架构每两三年就大幅迭代,存在技术贬值风险。
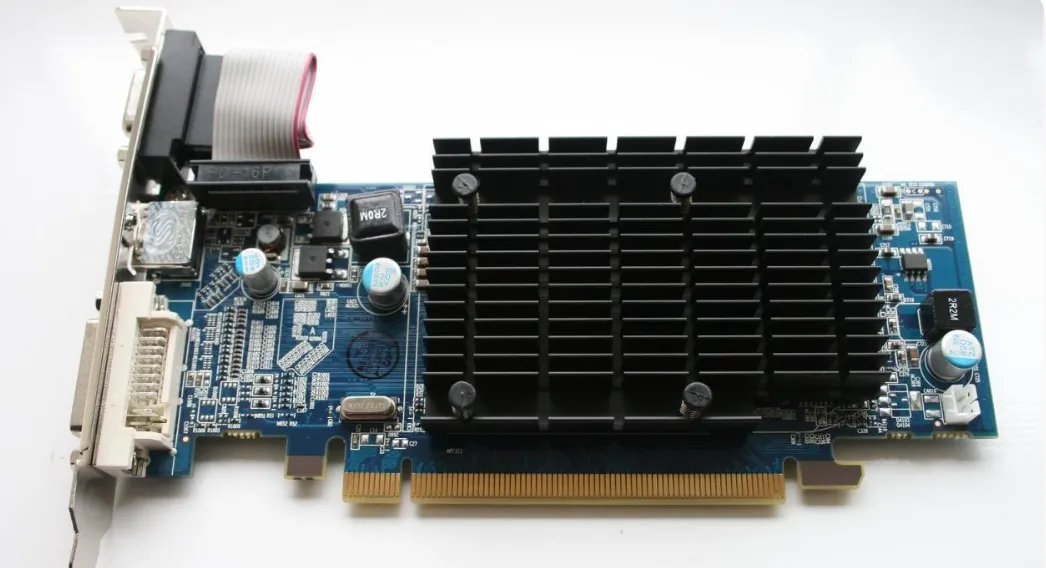
再看"租"。租用云GPU是一种轻资产模式。企业按小时或包月付费,A100按需约8至12元/小时,竞价实例更便宜,初期投入近乎为零,几分钟即可开通,用毕即释放。它让团队免于机房、散热、驱动与扩容之苦,还能随时调用H200等最新显卡做实验。代价是长期满负荷下累计费用可能超过自建,且数据需经公网,可通过VPC专网与TLS加密来缓解。研究显示,当算力利用率低于70%时,租用通常更划算。
对多数企业而言,最佳解法是混合架构:以自有GPU承载稳定的基础负载,用云算力应对峰值的弹性扩展与研发试错。不少头部企业便将核心推荐算法放在自有集群,而把新模型训练与A/B测试放到云端租用。行业调研也显示,到2025年底,多数AI项目已将云GPU作为主或辅算力平台,GPU即服务、无服务器机器学习等新模式正加速普及。一句话总结——长期、稳定、高利用率、强合规选"买";短期、波动、试错、轻资产选"租";尚不确定则先用云验证,再按需沉淀。把精力放在业务价值而非基础设施本身,才是算力决策的本质。