GPU算力中心之间并不只是简单地传输业务数据。对于AI训练、推理和大模型部署来说,不同算力中心之间会持续交换模型参数、训练数据、Checkpoint、任务调度信息以及日志等数据,而且数据量通常非常大。
首先是训练数据。AI模型训练需要大量文本、图片、视频、语音以及业务数据,这些数据可能存储在独立的存储集群、对象存储或者其他数据中心。当GPU算力中心需要训练某个模型时,就需要通过高速网络读取这些数据。如果数据不在本地,就会产生跨数据中心的数据传输。
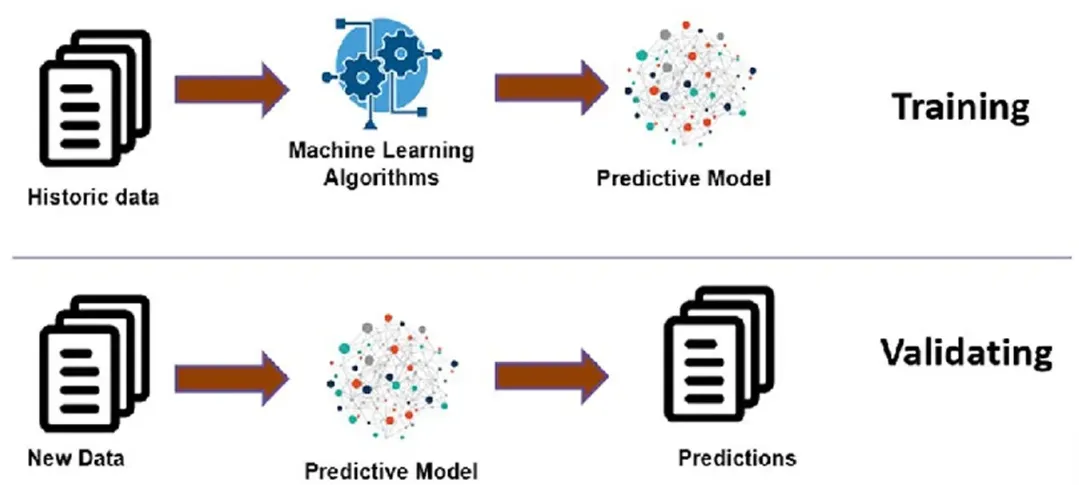
第二类是模型参数和梯度数据。这是GPU算力中心之间非常重要的一类流量。大型模型训练往往会使用多个GPU集群,甚至分布在不同的服务器和算力中心。训练过程中,GPU需要不断进行参数同步、梯度交换和状态更新。模型越大、GPU数量越多,对网络带宽和时延的要求就越高。
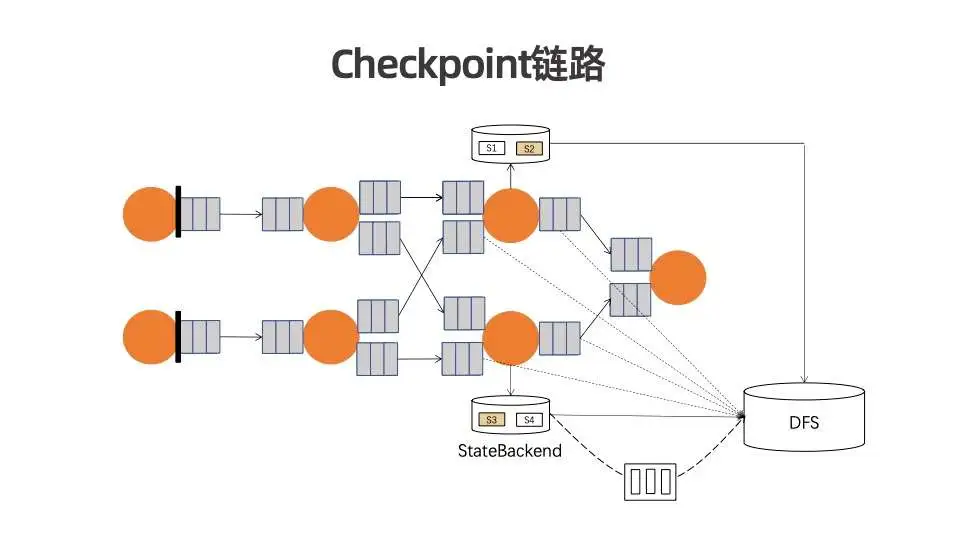
第三类是Checkpoint,也就是模型训练过程中的阶段性保存文件。训练一个大型模型可能需要持续运行数天甚至更长时间,因此通常会定期保存Checkpoint。一份Checkpoint可能达到几十GB、几百GB甚至更大。当算力中心之间进行任务迁移、容灾备份或者异地存储时,就需要传输这些文件。
另外还有模型文件。训练完成后,模型可能需要部署到不同地区的GPU算力中心。例如总部完成模型训练后,需要把模型同步到上海、深圳、新加坡或者东京的推理节点。这时候传输的可能包括模型权重、Tokenizer、配置文件以及相关运行环境数据。
还有一部分是业务和运维数据,包括任务调度信息、GPU状态、监控指标、日志、告警信息等。这些数据单次传输量可能不大,但对网络稳定性要求比较高。
所以,GPU算力中心之间的网络,本质上承担的是数据读取、模型训练同步、Checkpoint备份、模型分发以及算力调度等多种任务。尤其是在多地GPU集群协同训练的场景下,网络已经成为算力基础设施的重要组成部分。除了带宽要足够,还要重点关注时延、丢包率、抖动和链路稳定性。对于大规模算力中心,通常会采用高速以太网、InfiniBand、OTN、DWDM或者数据中心互联专线等方式,具体方案要根据GPU规模、数据量和跨地域距离来确定。