AI生成内容的能力正在从静态图片和视频,向可实时交互的虚拟环境发展。用户不仅可以生成一个场景,还能在场景中进行操作,并根据需要调整环境和物体状态。
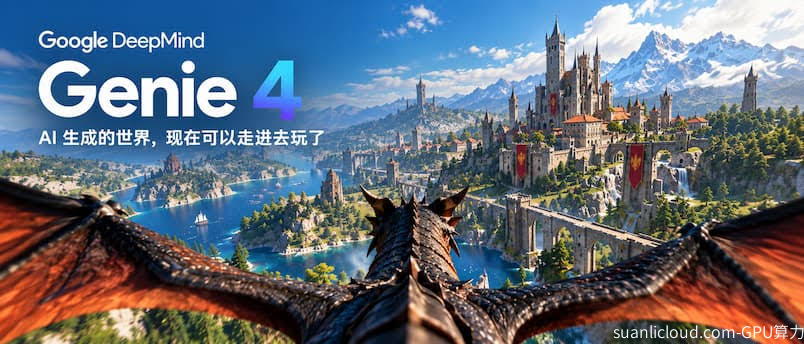
10月27日,Google DeepMind发布了 Genie 4,展示了AI生成可交互虚拟世界的技术能力。与传统的视频生成不同,这类技术不仅需要生成画面,还需要根据用户的操作,持续更新场景内容,并处理物体运动、环境变化等信息。用户可以通过文字指令创建虚拟场景,在场景运行过程中调整天气、添加物体或改变环境,同时获得相应的环境声音和人物对话。
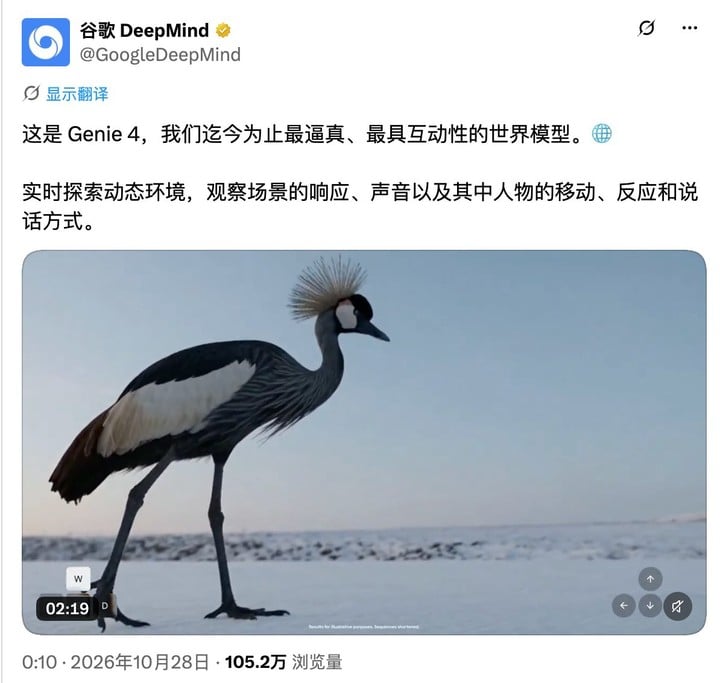
从技术角度看,生成可交互环境对AI提出了更高的要求。普通视频生成主要关注画面的连续性和内容表现,而交互式环境还需要考虑用户输入、物体位置、运动状态以及前后画面之间的一致性。例如,用户移动一个物体后,系统需要继续生成与新位置相符的画面;当环境发生变化时,场景中的其他元素也需要作出合理响应。这意味着模型不仅要生成视觉内容,还需要在连续运行过程中维持一定的空间关系和状态信息。
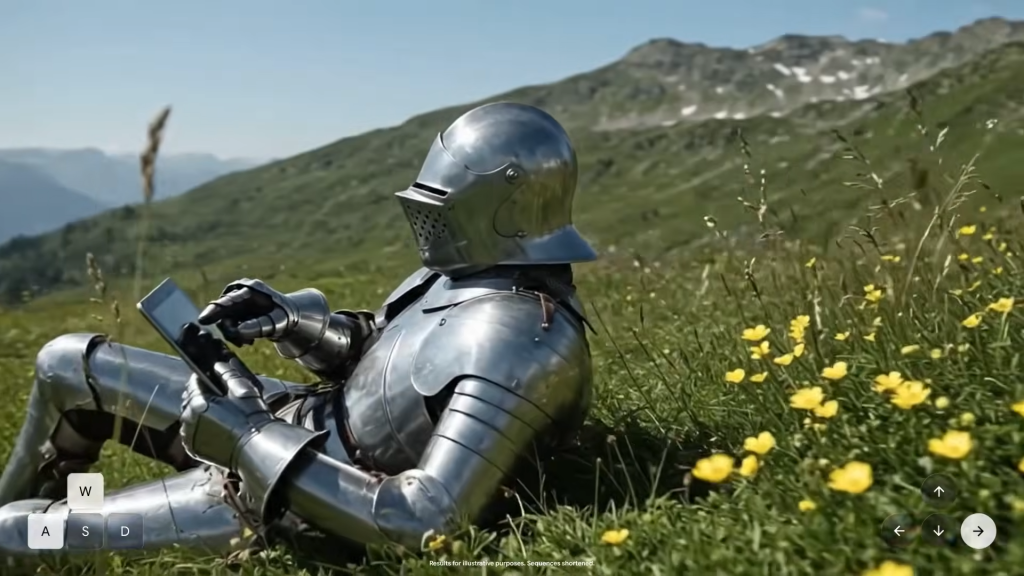
这项技术未来可能应用于多个领域。在游戏开发中,开发者可以通过文字快速创建场景,减少部分美术制作和环境搭建工作;在机器人训练中,研究人员可以生成不同的虚拟环境,让机器人在模拟条件下学习识别物体、规划路线和执行任务;在影视制作和虚拟仿真中,相关技术也有望用于场景预演、环境测试和交互式内容制作。
不过,可交互虚拟环境距离稳定的实际应用仍有一定差距。根据目前的研究方向,这类模型仍需要解决长时间运行时的场景一致性、物体状态保持和复杂交互响应等问题。如果用户连续进行多次操作,系统能否准确保留此前的场景变化,仍然是重要的技术考验。