AI 大模型不断发展,越来越多的 AI 公司开始抓取互联网公开内容,用于模型训练、知识库建设和实时搜索。对于网站所有者来说,网站上的文章、图片和技术资料被 AI 抓取,是否可以拒绝?答案是可以,但需要根据不同的抓取方式采取相应措施。
首先,需要区分 AI 抓取的具体用途。目前,AI 公司抓取网站内容主要有几种情况:一是用于大模型训练,让模型学习文章中的知识和语言规律;二是用于 AI 搜索,在用户提问时检索网站内容并生成答案;三是用于实时信息获取,为 AI 提供最新的新闻、产品和行业资料。这几种用途并不完全相同,网站所有者也需要针对不同类型的抓取设置限制。
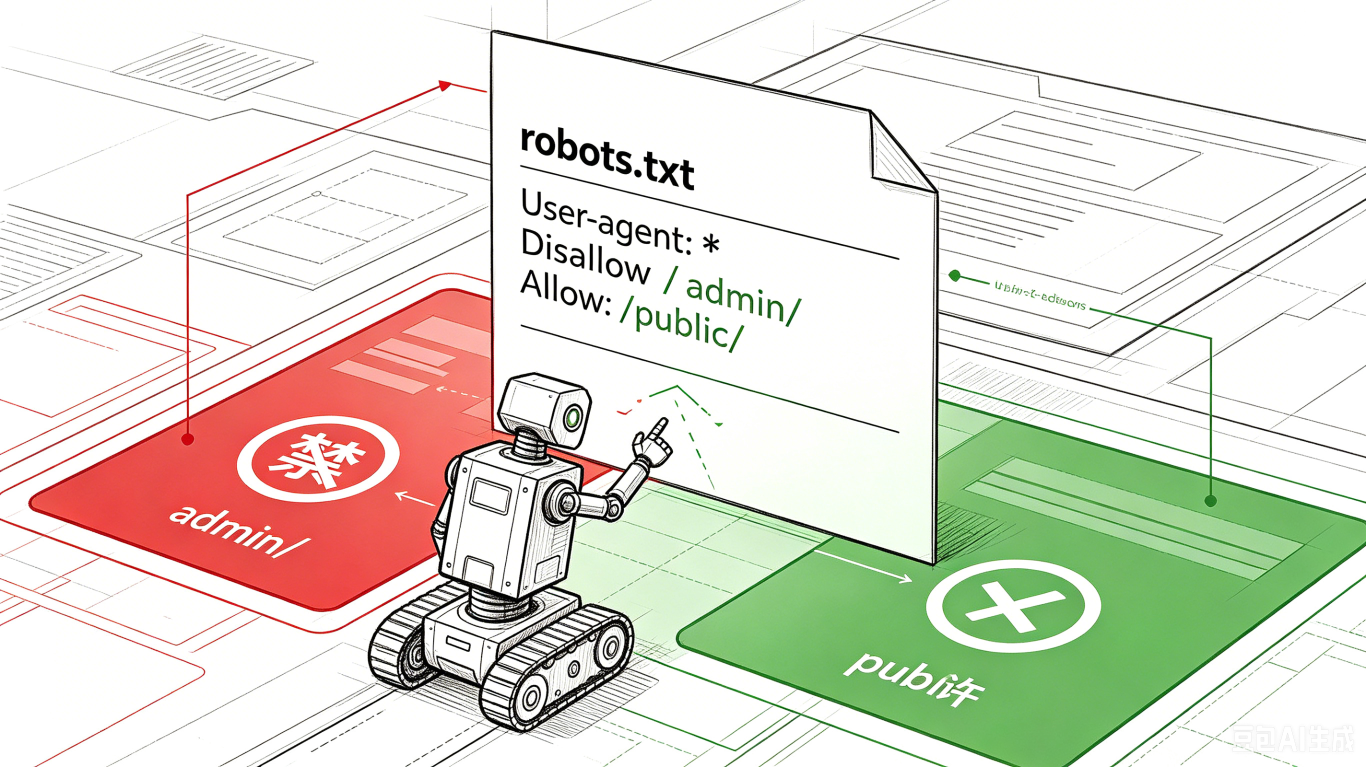
目前,比较常见的方式是通过 robots.txt 文件管理搜索引擎和 AI 爬虫的访问权限。网站管理员可以在网站根目录下配置该文件,指定哪些爬虫可以访问,哪些爬虫不能访问。例如,部分 AI 公司会使用 GPTBot、ClaudeBot 等爬虫抓取公开网页,网站可以针对这些爬虫设置禁止访问规则。
其次,网站还可以通过服务器防火墙、WAF和访问频率限制等方式管理爬虫。如果发现某个爬虫频繁请求网页,占用大量带宽或服务器资源,可以根据 User-Agent、IP 地址和访问行为进行识别,并采取限制请求、封禁 IP 等措施。
不过,需要注意的是,robots.txt 并不是强制性的访问控制机制,它主要是一种爬虫访问规则声明。遵守规则的爬虫会按照要求停止抓取,但并不能保证所有 AI 公司都会执行。如果网站希望进一步保护内容,还需要结合身份验证、访问权限控制和服务器安全策略。
另外,禁止 AI 爬虫访问,也不代表网站内容能够从互联网上彻底消失。如果内容此前已经被抓取、缓存或收录,相关数据可能仍然存在于第三方系统中。网站所有者还需要根据具体情况,向相关平台提出删除或停止使用内容的请求。