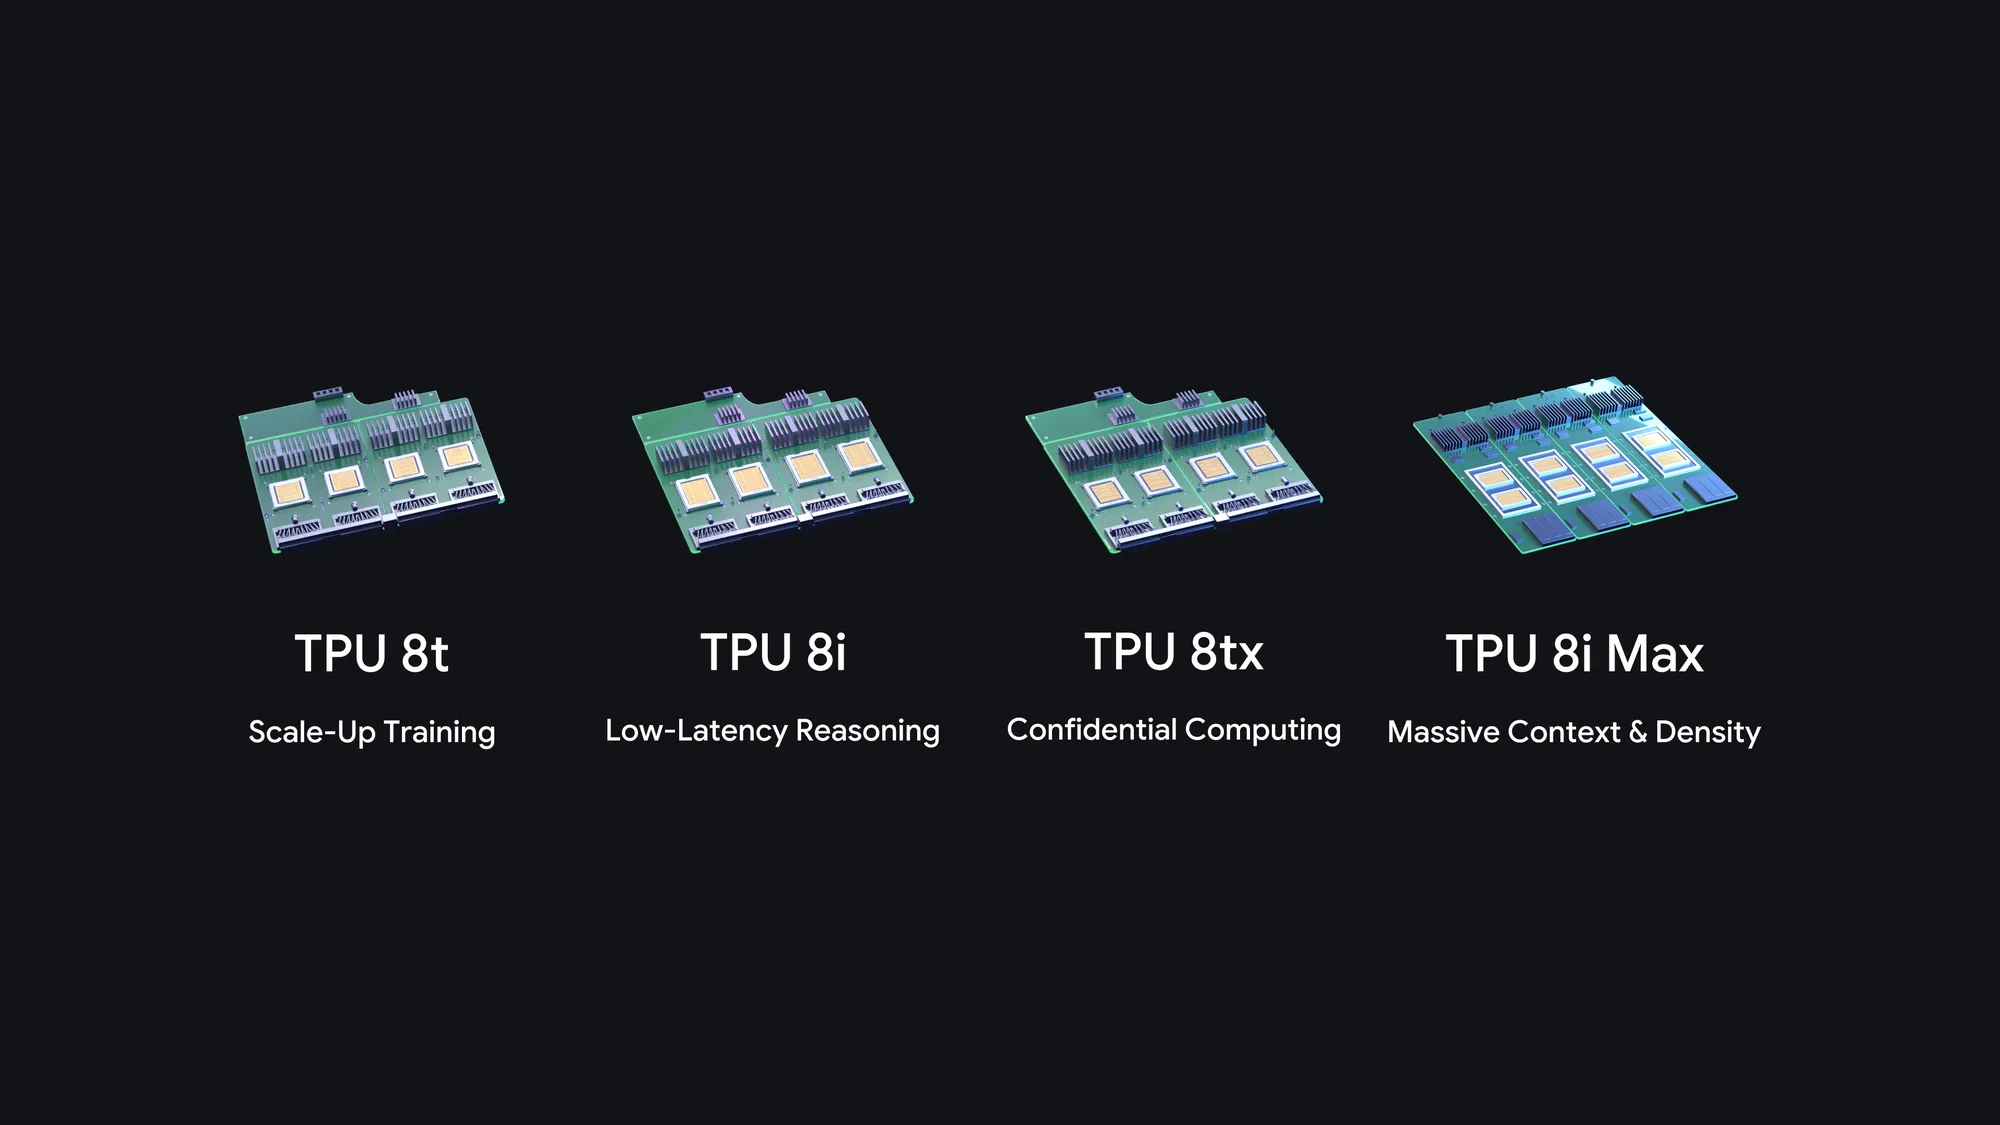
Google 近日扩展了第八代 TPU 产品线,推出 TPU 8tx 和 TPU 8i Max 两款新产品。两款芯片分别面向机密计算和大规模 AI 推理场景,重点提升数据安全、计算能力、内存带宽以及长上下文处理能力。这也反映出 AI 芯片的发展方向正在从单纯提升算力,逐渐转向计算、存储和数据安全的综合优化。
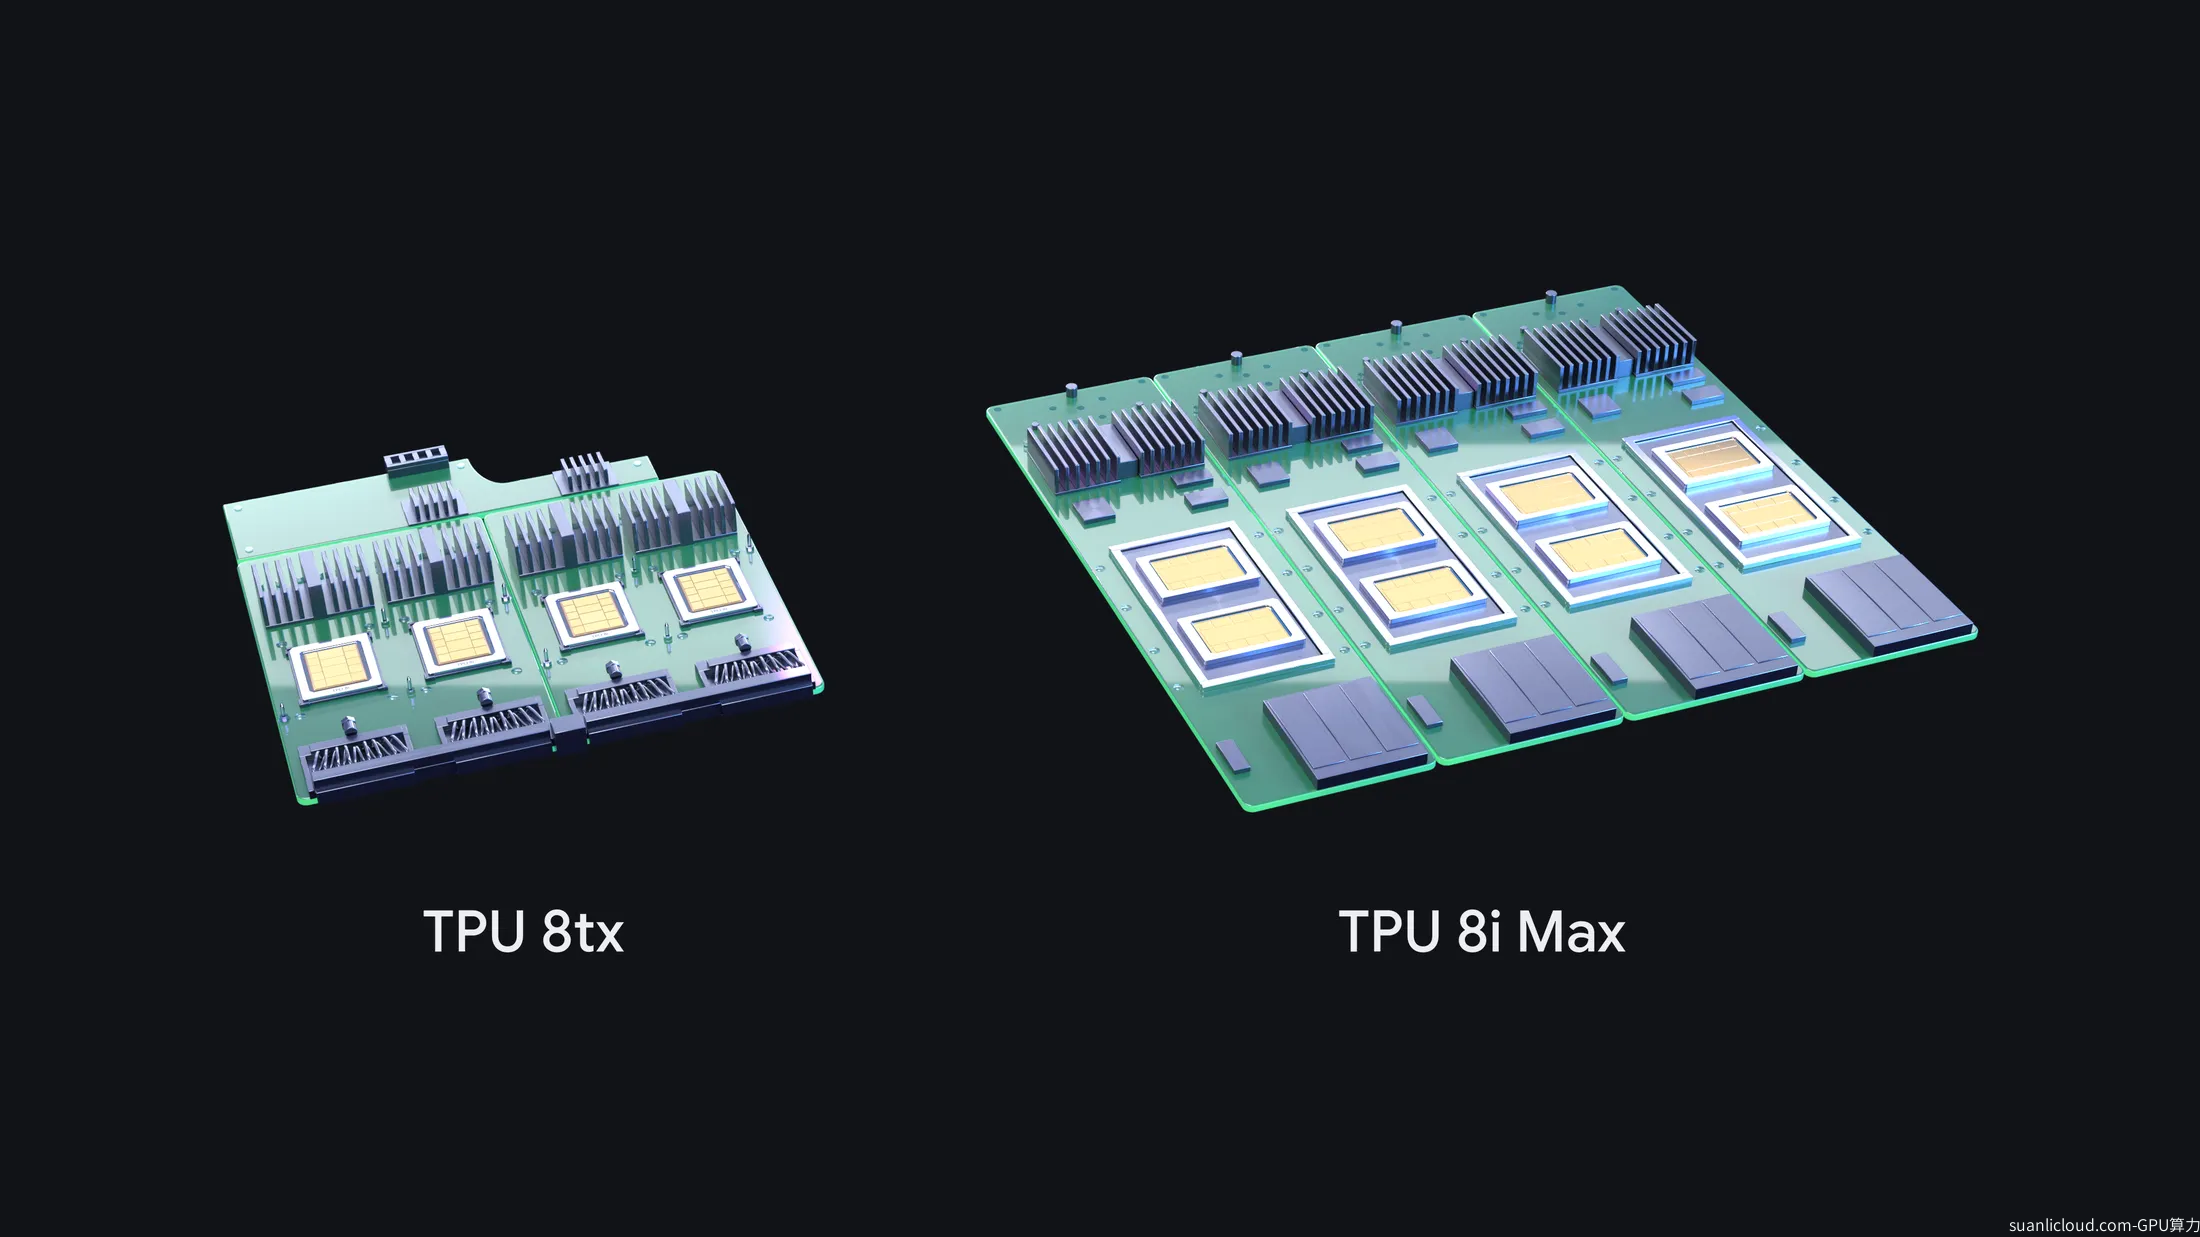
TPU 8tx 主要面向对数据安全要求较高的企业和机构。 例如政府部门、金融机构以及需要处理敏感数据的企业,在使用 AI 模型时,不仅需要保护数据传输和存储过程,还需要关注数据在计算过程中是否安全。TPU 8tx 重点强化了机密计算能力,通过硬件级安全机制,对运行中的敏感数据和模型权重提供保护,降低数据在处理过程中泄露的风险。这类设计有助于企业在使用云端 AI 算力时,更好地满足数据安全和合规要求。
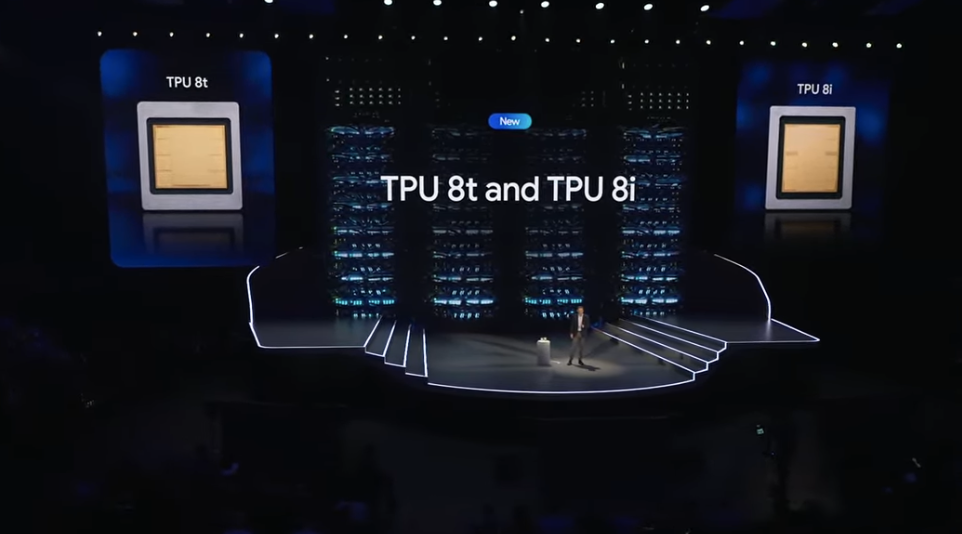
TPU 8i Max 则更关注大规模 AI 任务的运行效率。 随着大语言模型和智能体应用不断发展,模型需要处理的上下文越来越长,多个智能体之间也需要频繁交换信息,这对芯片的计算能力、内存容量和数据传输速度提出了更高要求。TPU 8i Max 采用双芯片封装设计,进一步提升计算能力、片上存储和 HBM 高带宽内存带宽,能够更好地支持长上下文处理、多智能体协作等任务。
除了硬件升级,Google 还推出了配套的 TPU Sync 技术,用于统一管理芯片 HBM、主机 DRAM、共享存储和数据中心网络。对于需要处理百万级 Token 上下文的 AI 应用来说,模型运行过程中会产生大量 KV Cache 数据,如果全部依赖芯片内部显存,容易受到容量和带宽限制。TPU Sync 可以将不同层级的存储资源进行统一调度,减少数据传输带来的延迟,提高集群整体运行效率。
从这次发布可以看出,Google 已经不再只关注 TPU 的单芯片计算性能,而是开始针对不同 AI 应用场景,分别优化计算、内存、安全和网络能力。尤其是 AI Agent 和长上下文应用不断增加之后,算力集群需要处理的数据量和协作任务都在增长,单纯增加 GPU 或 TPU 数量并不能解决所有问题。未来,芯片性能、内存带宽、存储调度和数据中心网络之间的配合,也将成为 AI 算力基础设施的重要发展方向。