Embedding(向量化)是人工智能中的一项基础技术,它可以将文字、图片等信息转换成计算机能够处理的数字向量,让 AI 能够识别不同内容之间的语义关系。在大模型应用、RAG 知识库和智能搜索中,Embedding 都发挥着重要作用。
一、什么是 Embedding?
Embedding 是一种将非结构化数据转换成数字向量的技术。以文字为例,当用户输入一句话时,Embedding 模型会对文字进行编码,生成一组由数字组成的向量。例如,一段文字经过处理后,可能会得到 [0.12、0.35、0.68……] 这样的数字序列。

这些数字并不是随机生成的,而是通过模型训练得到的。不同文字会根据语义、上下文和表达内容形成不同的向量。意思相近的文字,通常会在向量空间中表现出较高的相似度。
二、为什么 AI 要把文字转换成向量?
计算机本身并不能像人一样直接理解文字的含义,而向量可以将文字内容转化为可计算的数据。通过向量之间的距离和相似度计算,AI 就能够判断不同内容在语义上是否接近。
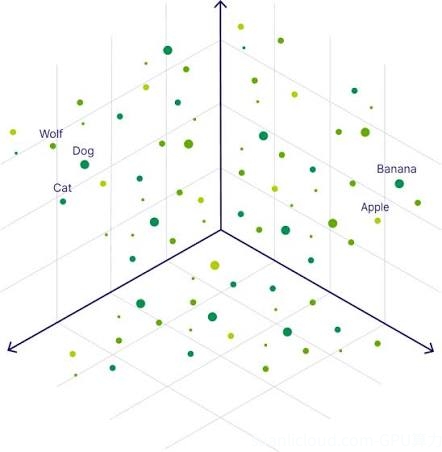
例如,用户搜索“如何降低服务器运行成本”,即使知识库中没有完全相同的句子,但存在“服务器租用怎样节省费用”“降低数据中心运营开支”等内容,系统也可以通过向量相似度找到相关信息,而不只是匹配相同的关键词。
三、Embedding 在 AI 中有哪些应用?
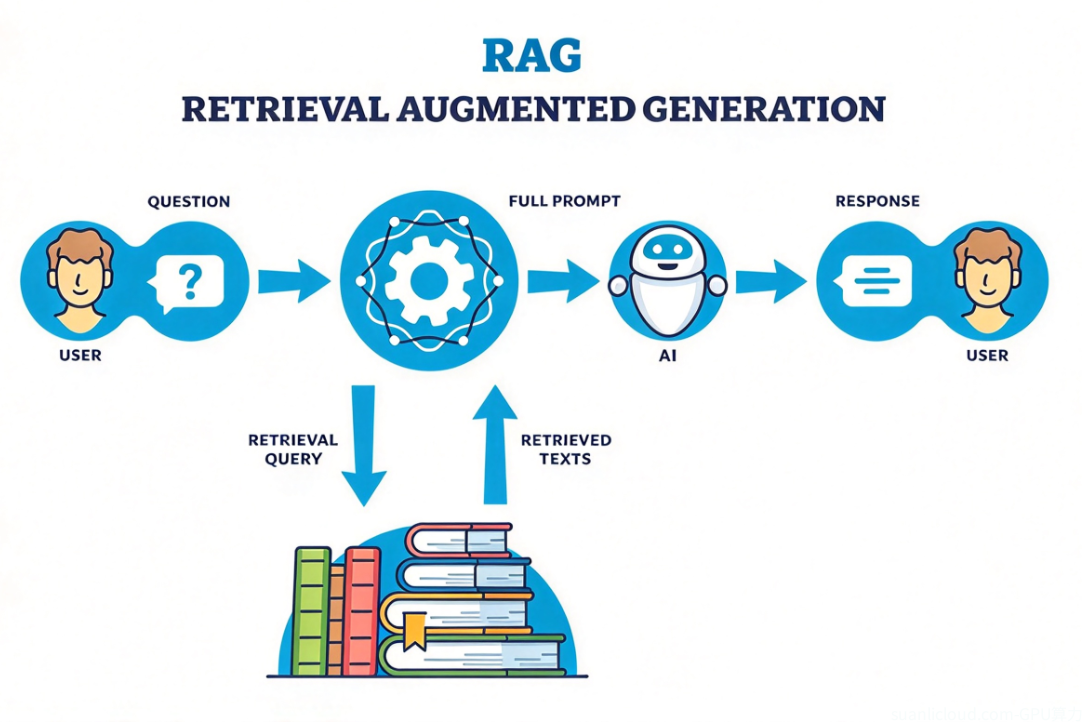
Embedding 最常见的应用是语义搜索、RAG 知识库和智能推荐。在 RAG 系统中,企业会先将文档拆分成多个文本片段,再通过 Embedding 模型转换成向量,存储到向量数据库中。当用户提出问题时,系统会将问题同样转换成向量,检索出语义最接近的内容,再交给大语言模型生成回答。
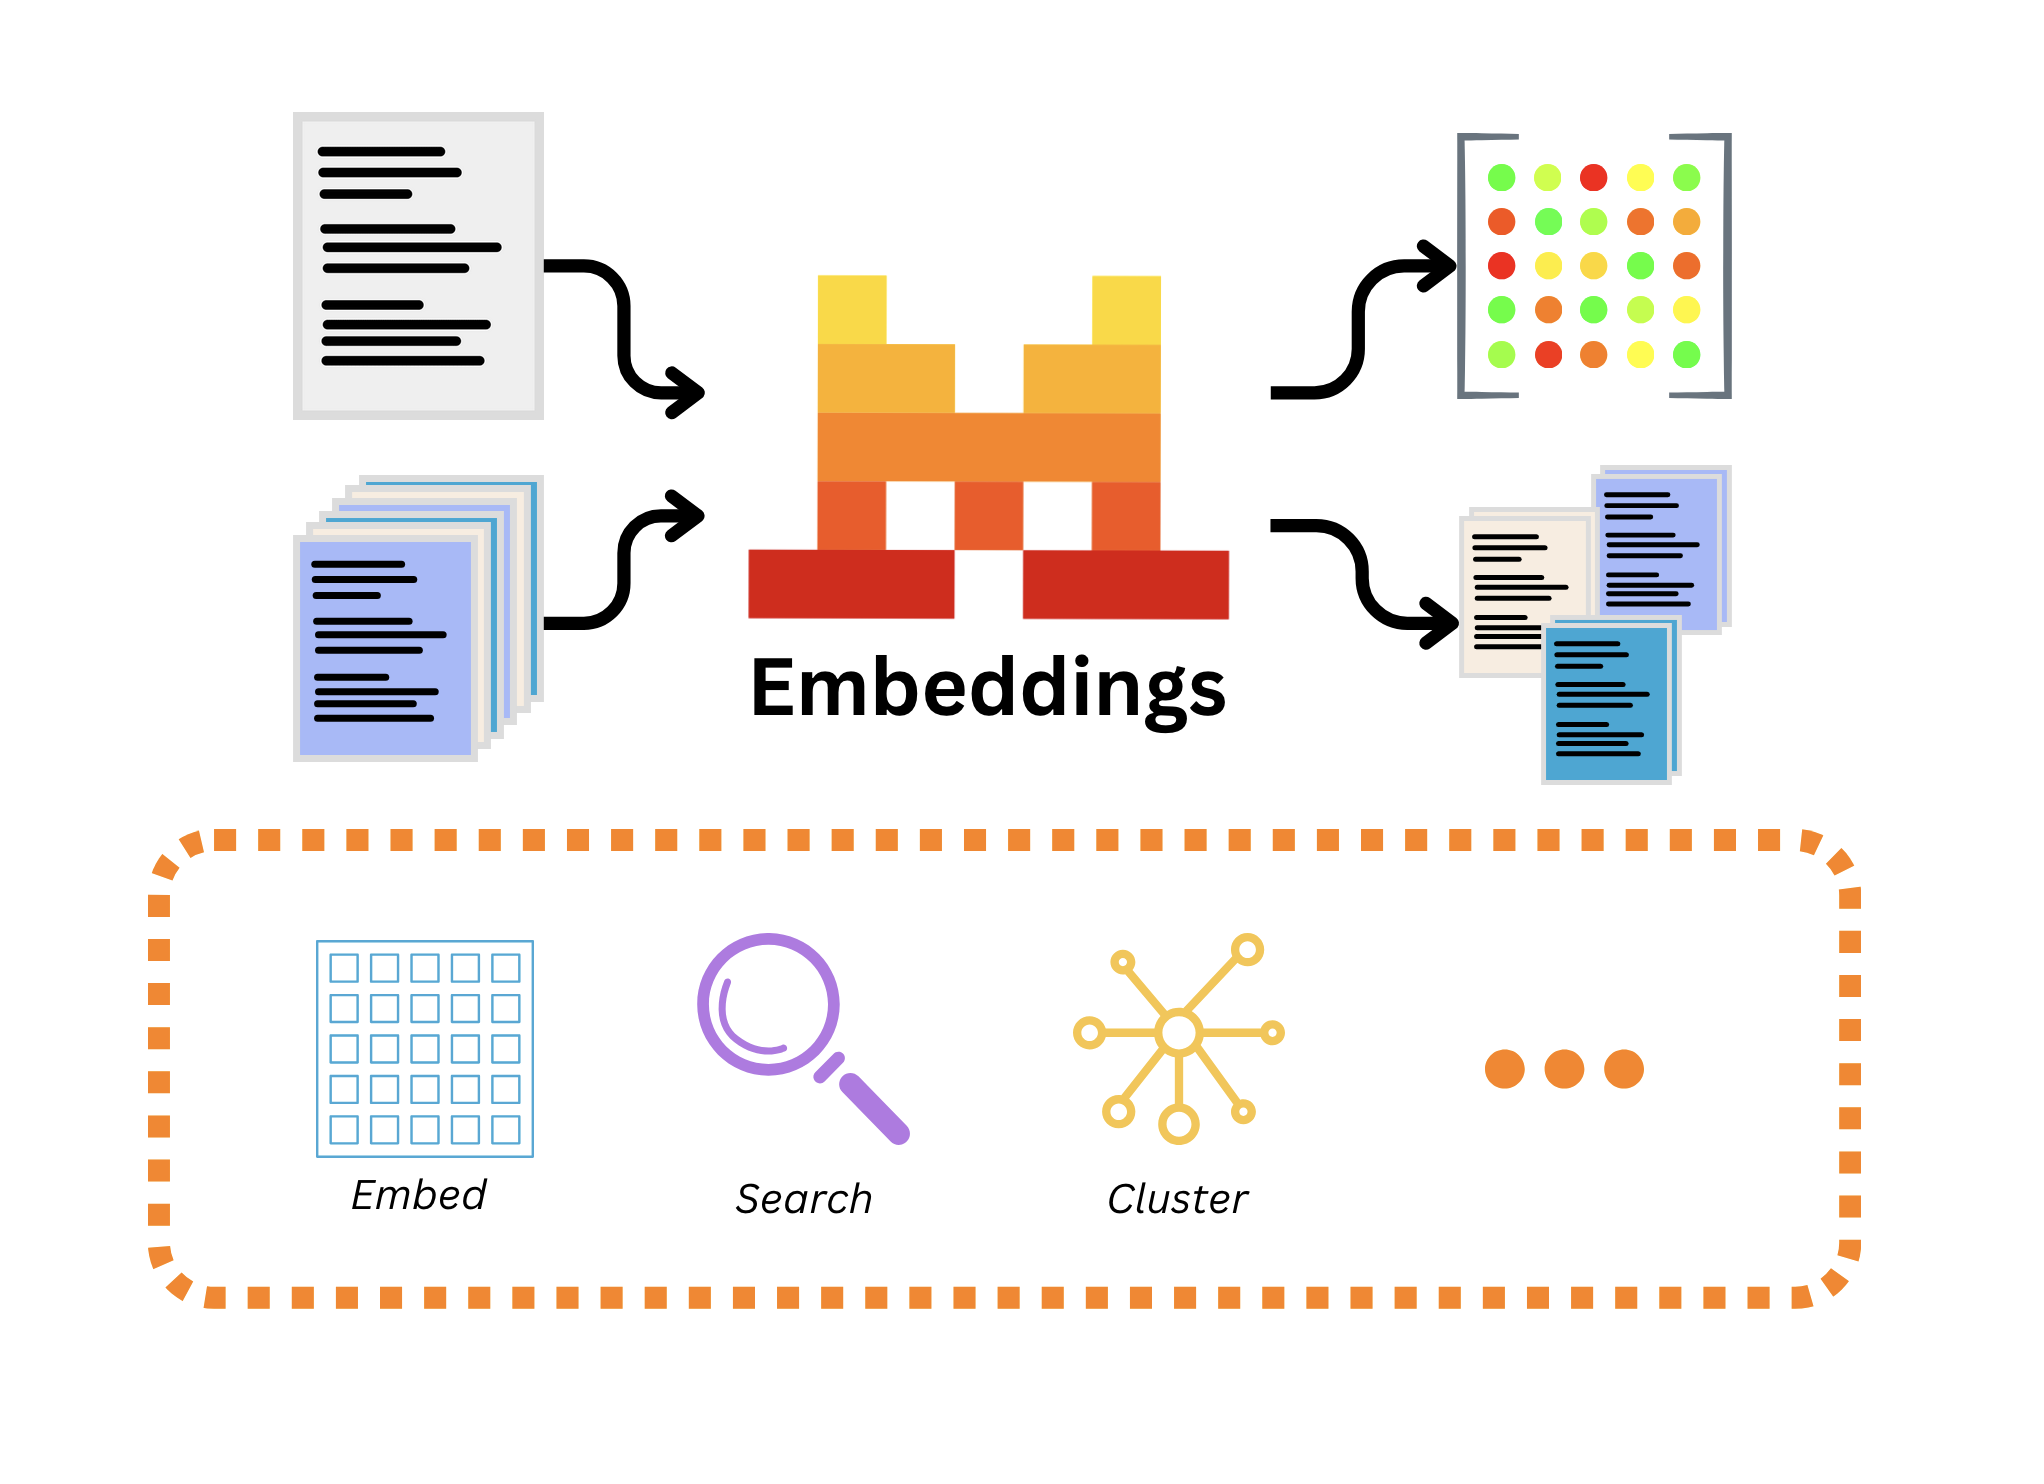
此外,Embedding 还可以用于文本分类、内容推荐、图片检索以及不同类型数据之间的关联分析。
需要注意的是,Embedding 本身并不负责生成答案,它主要负责内容编码和语义检索。真正的回答通常还需要大语言模型参与。
对于企业 AI 应用来说,Embedding 能够帮助系统更准确地检索内部资料,提高知识库的检索效率,也是构建 RAG、智能客服和企业知识管理系统的重要基础技术。