跨地域GPU算力调度,简单来说,就是把分布在不同城市、不同数据中心的GPU资源统一管理,根据任务需求、GPU资源情况和网络状态,把任务调度到合适的算力节点执行。对于拥有多个GPU集群的企业来说,这种方式可以提高GPU资源利用率,也方便统一管理。
具体来看,跨地域GPU调度通常需要解决三个问题:GPU资源怎么统一管理、任务怎么分配、不同地域之间怎么通信。
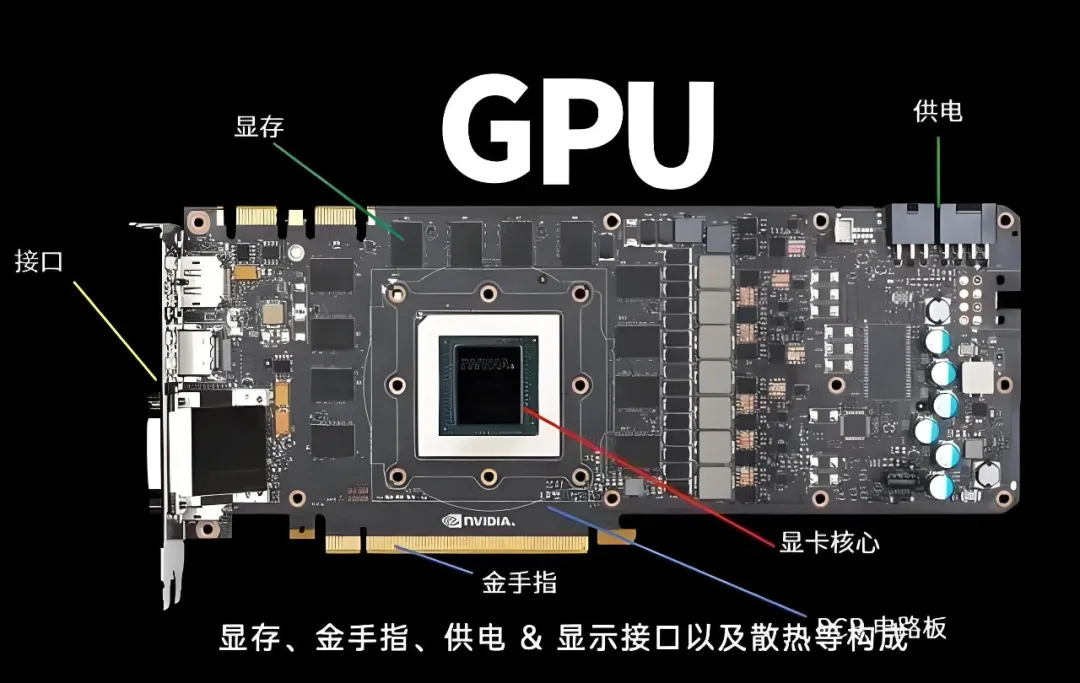
首先是GPU资源统一管理。假设企业在北京、上海、东京分别部署了GPU服务器,每个地方都有独立的GPU集群。企业可以通过Kubernetes、Slurm等集群管理和调度系统,把不同地域的GPU节点纳入统一的资源管理体系。系统可以持续获取每个节点的GPU型号、显存、GPU利用率、CPU、内存以及当前任务数量等信息。
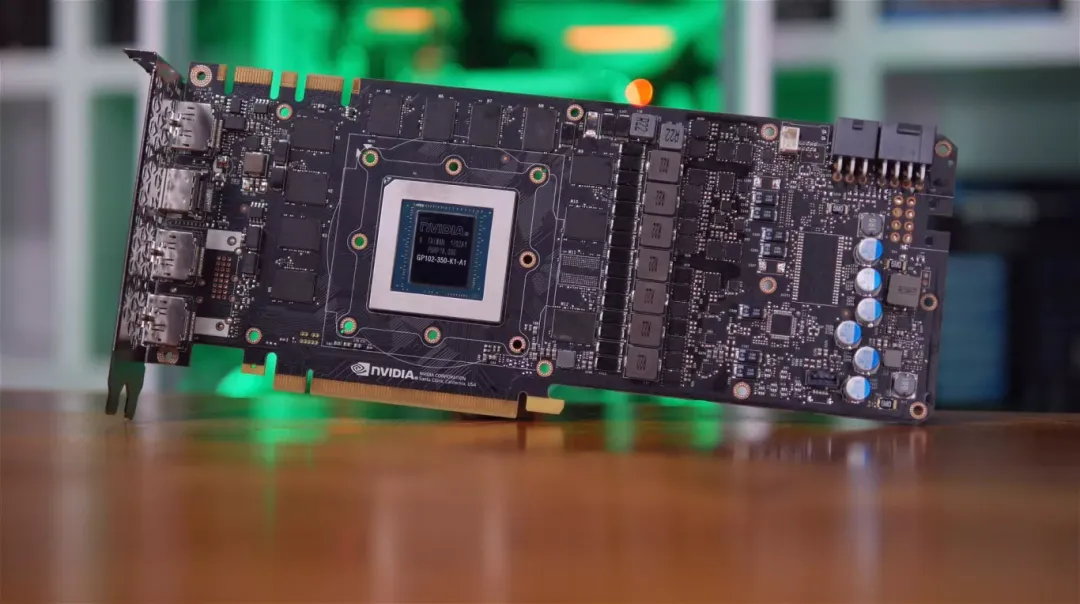
其次是任务调度。用户提交一个AI训练或者推理任务后,调度系统会根据任务需要选择合适的GPU。例如任务要求8张H100,并且需要较大的显存和高速GPU互联,系统就会优先寻找满足这些条件的节点。如果本地GPU资源不足,也可以把任务调度到其他地域的集群。实际调度时还需要考虑GPU空闲程度、任务优先级、数据所在位置以及网络延迟等因素。
第三就是跨地域网络。GPU服务器真正开始工作后,可能需要访问远端的数据集、模型文件、Checkpoint或者其他GPU节点。如果不同数据中心之间只有普通互联网,延迟、丢包和带宽稳定性可能影响任务运行。因此企业通常会使用专线、OTN、DWDM、高速以太网或者SD-WAN等方式连接不同GPU集群。对于需要多机多卡训练的任务,还要重点考虑RDMA、RoCE、网络带宽和低延迟通信。
另外,跨地域调度并不是简单地把任务“扔到另一台服务器”。数据怎么传、模型怎么同步、任务失败后怎么恢复,都需要提前设计。例如训练数据可以放在靠近GPU集群的存储系统中,Checkpoint定期同步到其他数据中心;推理业务则可以根据访问用户所在区域和GPU资源情况,把请求调度到不同地域。
所以,一个比较完整的跨地域GPU算力架构通常包括统一调度平台、多个GPU集群、高速数据中心互联网络、分布式存储以及监控系统。最终实现的目标,就是让企业能够统一看到不同地域的GPU资源,并根据任务需求和实时资源状态进行动态分配,而不是每个数据中心各自管理自己的GPU服务器。