MoE(Mixture of Experts,混合专家模型)是目前大模型领域比较热门的一种模型架构。它的主要特点是:模型可以根据输入内容,动态选择部分网络参与计算,而不需要每次都调用全部参数。这样能够在保持模型规模的同时,降低计算开销。
一、什么是 MoE 模型?
传统的稠密模型在处理每一个 Token 时,通常都会激活模型中的大部分参数。例如,一个拥有70B参数的稠密模型,在推理过程中,每个 Token 都需要经过相应的模型层进行计算。
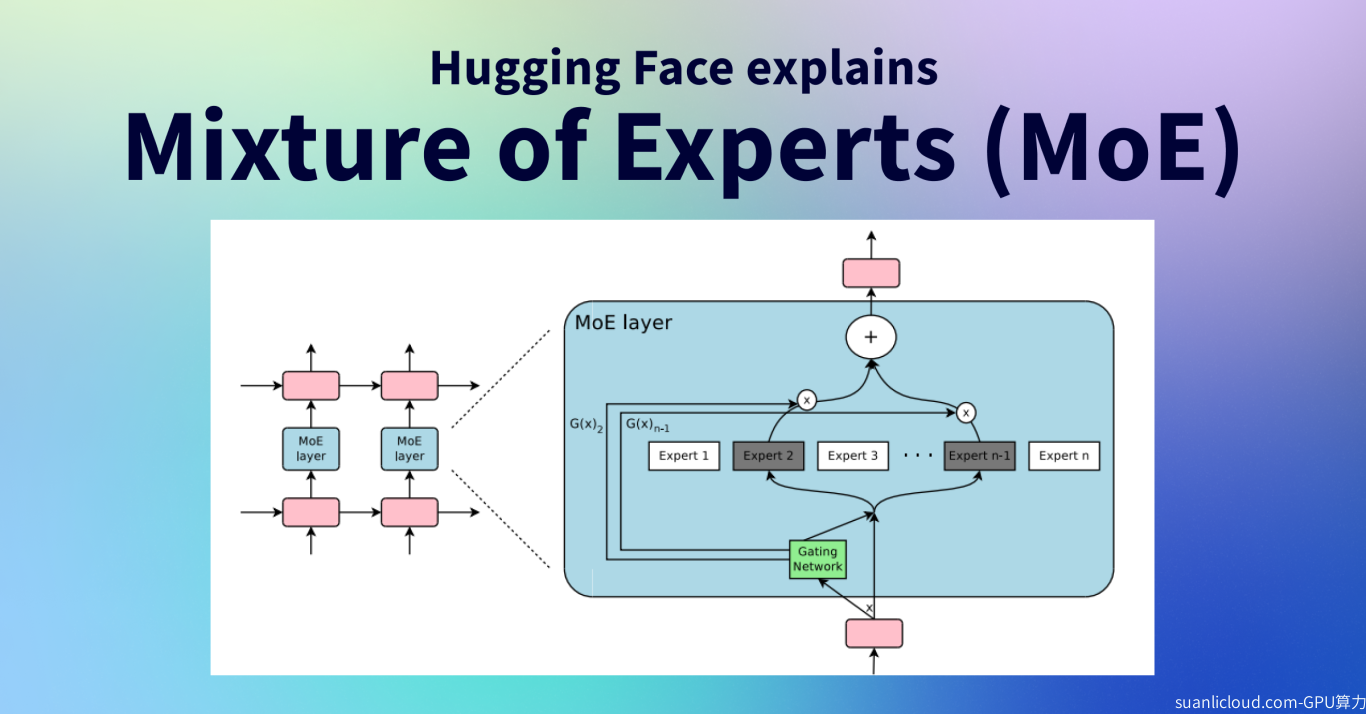
而 MoE 模型采用了不同的设计。它会将模型中的部分网络划分为多个专家模块,每个专家可以学习不同类型的特征和知识。同时,模型还会配置一个路由网络,根据输入内容判断应该调用哪些专家参与计算。
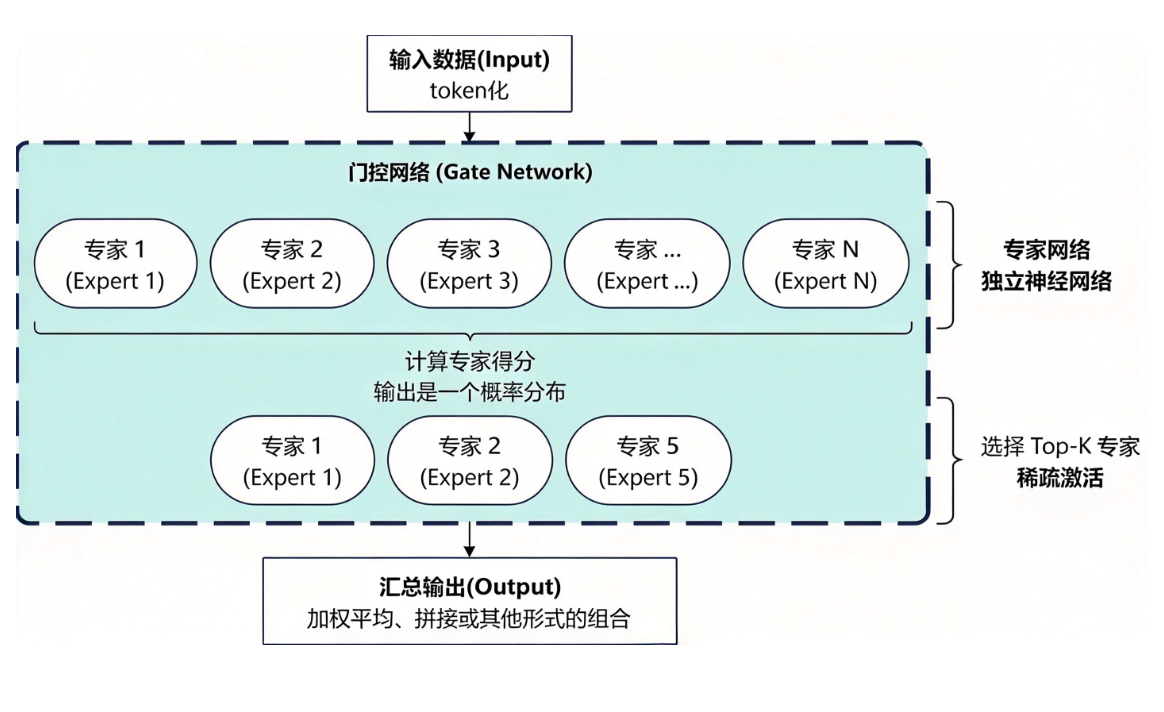
例如,一个 MoE 模型拥有8个专家,每次处理 Token 时,只选择其中2个专家参与计算。这样就不需要让全部专家同时工作,从而减少实际计算量。
二、为什么很多大模型开始使用 MoE?
主要原因是它能够提高计算资源的利用效率。
首先,MoE 可以在增加模型总参数量的同时,控制每次推理需要激活的参数规模。模型可以拥有更多参数来学习复杂知识,但每次计算只调用其中一部分,因此有机会降低推理成本。
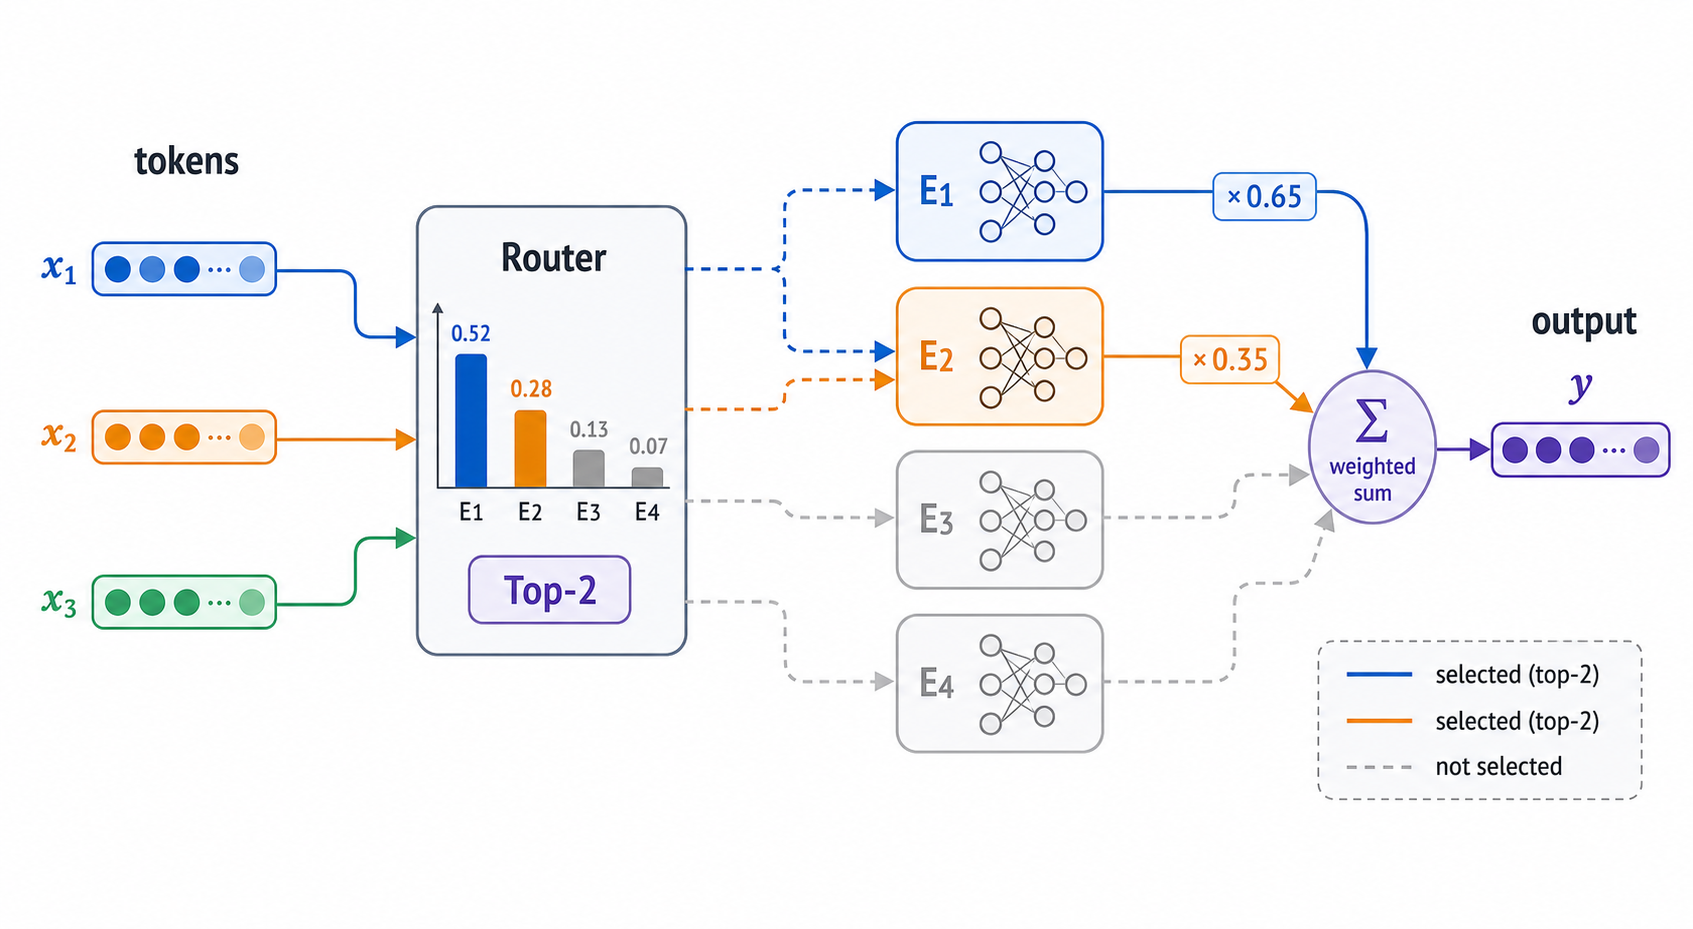
其次,MoE 有利于模型扩展。随着训练数据和模型规模不断增加,传统稠密模型需要投入更多计算资源,而 MoE 可以通过增加专家数量扩展模型容量,不必让所有新增参数都参与每次计算。
另外,MoE 还可以让不同专家逐渐形成不同的特征处理能力,提高模型处理复杂任务的能力。不过,专家是否真正形成有效分工,还取决于训练方法和路由机制。
三、MoE 模型有什么缺点?
MoE 并不是没有成本。虽然它减少了每次计算激活的参数量,但模型仍然需要存储全部专家参数,对显存容量和内存带宽有较高要求。
同时,路由网络需要合理分配计算任务。如果部分专家被频繁调用,而其他专家很少参与计算,就可能出现负载不均衡,影响整体运行效率。
此外,多个专家分布在不同 GPU 上时,还可能产生额外的通信开销。
四、MoE 和传统稠密模型有什么区别?
简单来说,稠密模型通常需要激活更多参数参与计算,而 MoE 可以根据输入动态选择部分专家。两者各有优势,稠密模型架构相对简单,MoE 则更适合在计算资源允许的情况下扩大模型容量。
随着大模型参数规模不断增长,MoE 已经成为重要的模型架构方向之一。它能够在模型能力、推理计算量和硬件成本之间提供新的平衡方案。