AI模型现在卷到什么程度了?
以前我们用AI,通常是输入一段文字,让它回答问题。后来可以上传图片,再后来,视频也开始成为模型能够处理的内容。
11月16日,阿里云百炼上线通义千问新一代旗舰模型 Qwen4-Max。这次比较有意思的是,它不仅支持文本、图片和视频输入,还把100万Token上下文、深度思考以及工具调用能力整合到了一起。
简单来说,AI不光能看懂更多内容,还能根据任务需要调用外部工具继续工作。
100万Token,究竟能装下多少东西?
先说这次比较受关注的百万上下文。
Token是AI处理文字时使用的基本单位,并不完全等于汉字或单词。100万Token的上下文长度,意味着模型一次任务能够接收规模非常庞大的信息。
举个例子,假设一家企业积累了大量产品说明书、技术文档、历史合同和会议记录,过去需要人工筛选、整理,再分批交给AI分析。拥有超长上下文能力后,就可以将更多资料放进同一个任务中,让模型进行归纳、检索和关联分析。
当然,100万Token不代表模型能一次生成100万Token的答案,它主要指模型能够接收和处理的上下文规模。
对于需要处理大量资料的企业来说,这项能力还是相当实用的。
更有意思的是,这次AI还能直接理解视频。
Qwen4-Max支持文本、图片和视频输入。
这意味着用户不必只依赖视频字幕或人工整理的文字资料,也可以直接将视频交给模型分析。
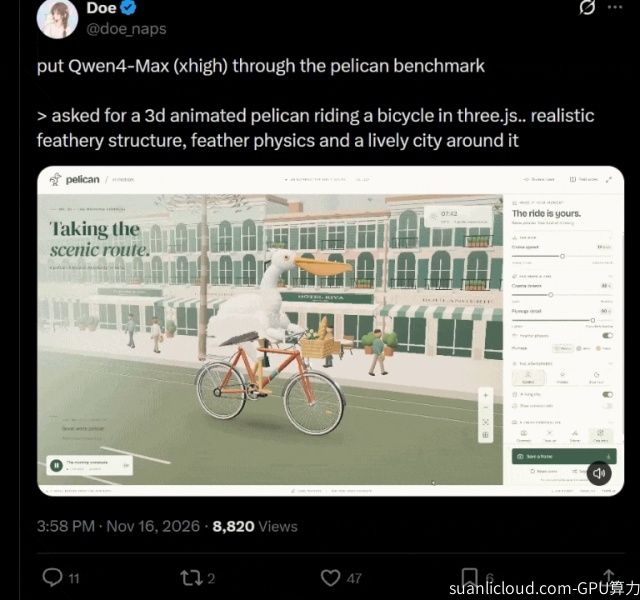
Qwen4-Max生成的醍醐骑自行车视频
例如,一家工厂上传一段设备运行视频,可以要求AI识别画面中的设备、分析运行过程,并结合已有技术资料整理出异常情况报告。
如果是电商团队,也可以上传一段商品展示视频,让模型提取产品外观、使用步骤和关键卖点,再生成商品介绍。
不过要注意,视频理解并不意味着AI已经具备完整的视频生成能力,具体识别效果也需要结合视频质量和实际任务测试。
但这次真正值得关注的,还不只是AI能看什么,而是它能调用什么。
Qwen4-Max支持Function Calling,也就是函数调用。
这个功能听起来有点技术化,其实理解起来并不复杂。
假设你让AI查询某款GPU的最新市场价格,并整理一份竞品对比表。
模型首先需要理解你的要求,然后根据任务调用联网搜索工具,获取相关信息,再对数据进行整理。如果还需要制作表格,它可以继续请求外部程序调用相应工具,最终把结果交给你。
这里需要注意,模型本身并不是直接拥有所有软件的操作权限,而是通过预先配置的工具接口,由外部程序执行具体操作。
除此之外,Qwen4-Max还支持并行工具调用和深度思考,可以根据任务需要调用多个工具,减少复杂工作中的重复步骤。

接口兼容性也值得一提。
官方文档显示,Qwen4-Max支持OpenAI Chat Completions、Responses以及Anthropic Messages等接口协议。这对于开发者来说比较方便,能够降低接入和迁移的工作量,但具体兼容程度仍要以各接口支持的参数和功能为准。
另外,阿里云还列出了北京、新加坡、法兰克福、美国弗吉尼亚、东京和中国香港等服务区域,方便不同地区的开发者根据业务需求选择部署和调用区域。
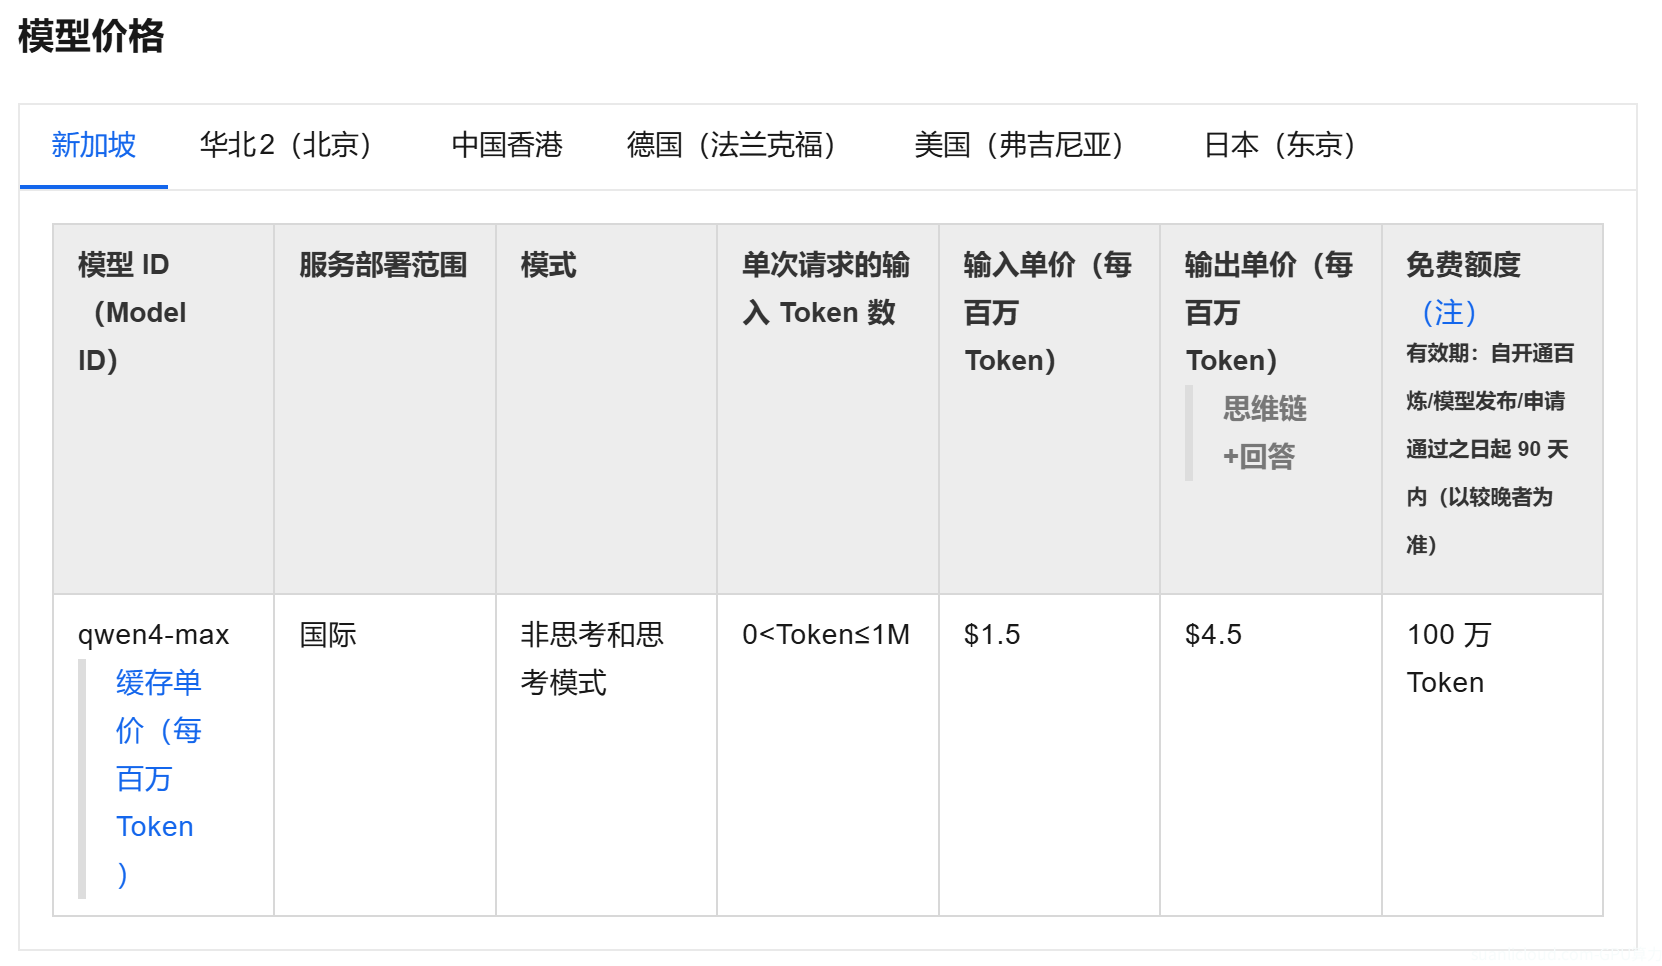
Qwen4-Max模型价格
整体来看,Qwen4-Max这次升级,重点已经不只是让模型回答问题更准确,而是让它能够接收更复杂的信息,再结合外部工具完成多步骤任务。
从理解文字、识别图片,到分析视频、调用工具,AI正在逐渐从内容生成走向实际工作流程。
对于企业来说,未来真正值得关注的,可能不只是哪个模型的参数更多,而是谁能以更低的成本、更稳定的效果,把实际业务任务完成。