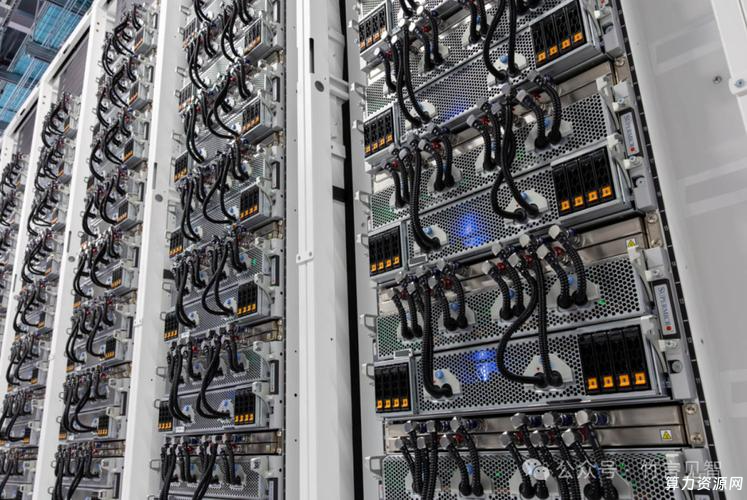
AI大模型训练、分布式推理和算力资源调度需求不断增加,企业可能会在不同城市建设多个算力中心。但GPU集群之间需要频繁交换数据,如果两个算力中心之间的网络带宽不足、延迟过高或链路不稳定,就会直接影响任务执行效率。那么,两个异地算力中心应该如何实现高速互联?
目前,异地算力中心之间通常采用DCI技术,通过高速专线建立跨地域网络连接。与普通互联网连接相比,DCI更注重带宽、时延、丢包率和链路稳定性,能够满足大规模数据传输和算力资源协同的需求。
在具体部署时,首先需要根据两个算力中心的地理位置、业务流量和数据传输规模选择合适的传输线路。如果是同城或距离较近的算力中心,可以考虑采用光纤直连、OTN等技术;如果是跨城市、跨区域互联,则可以选择MPLS专线、OTN专线或运营商提供的高带宽DCI专线。对于GPU集群之间需要频繁交换训练数据的场景,建议根据实际需求配置100G、200G甚至400G的网络接口,避免网络带宽成为计算任务的瓶颈。
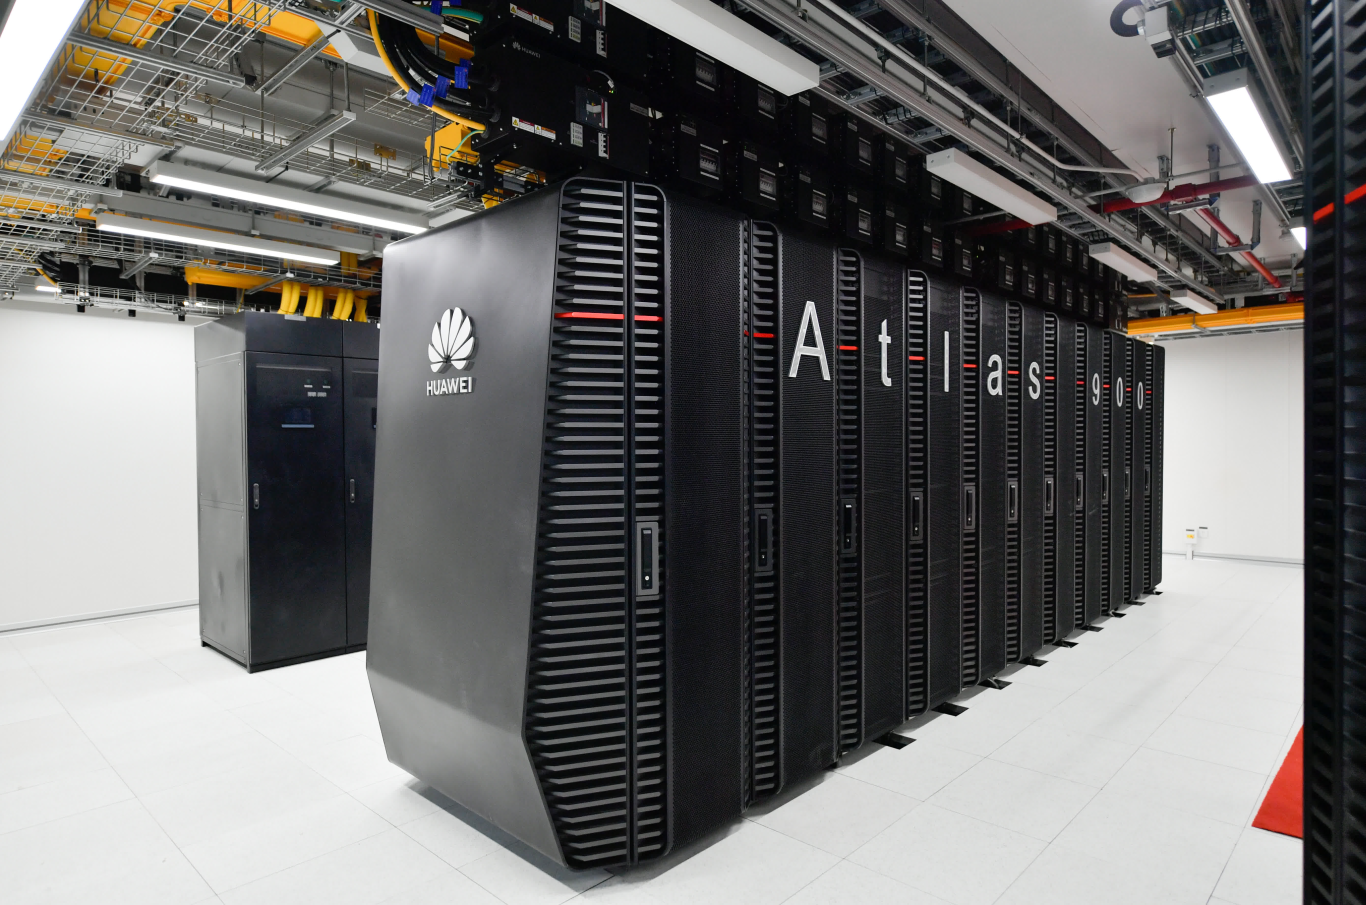
来源:中国新闻
其次,需要做好网络架构设计。两个算力中心可以分别部署核心交换机或数据中心交换设备,通过高速链路实现二层或三层互联。如果涉及多个算力中心,还可以采用IP骨干网或EVPN等技术,实现不同节点之间的灵活通信。同时,应根据业务需求划分网络,将GPU计算流量、存储同步流量和管理流量进行隔离,避免不同类型的业务相互影响。
另外,网络冗余也非常重要。对于承担AI训练、推理和数据同步任务的算力中心,建议部署双路由、双链路或不同运营商的备用线路。当主线路出现故障时,可以通过路由切换保障业务连续性。
需要注意的是,算力中心互联不能只关注带宽,还要关注端到端时延、丢包率、抖动以及网络拥塞情况。尤其是分布式训练场景,GPU节点之间需要进行大量通信,网络性能不足可能导致GPU等待数据,降低整体集群利用率。
因此,两个异地算力中心实现高速互联,需要综合考虑传输线路、网络架构、带宽规划和冗余保护。通过建设稳定可靠的DCI专网,可以让不同地域的算力资源实现高效通信,为分布式训练、跨区域推理和算力资源统一调度提供网络支撑。