两个GPU算力中心如果需要共同进行AI训练、模型推理或者大规模数据交换,普通公网通常很难满足要求。真正的高速互联,需要从专线、带宽、网络设备、路由和链路冗余几个方面一起规划。
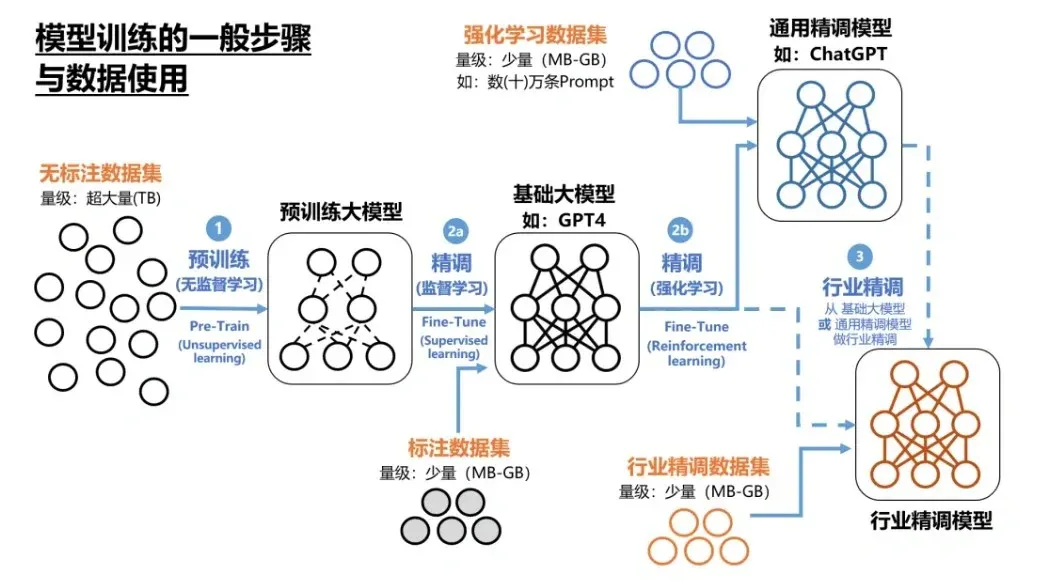
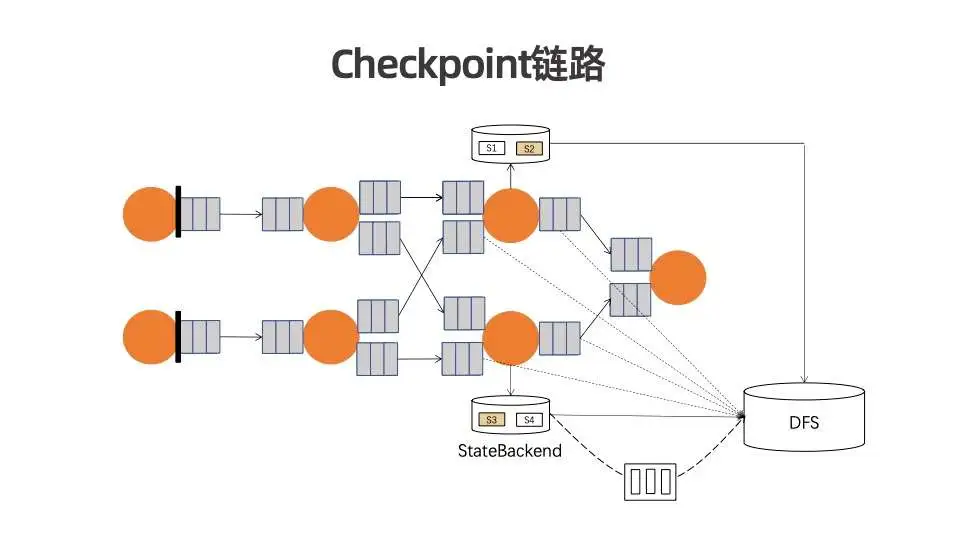
首先要确定两个算力中心之间到底传什么数据。如果只是模型文件、数据集和Checkpoint传输,对实时性要求相对低,可以采用高带宽互联网专线或者云专线。如果两个GPU集群需要进行分布式训练,服务器之间会持续交换模型参数、梯度和中间数据,这时候对带宽、时延和丢包率的要求都会明显提高,更适合建设IDC之间的专用互联网络。
在实际部署中,比较常见的是采用MPLS专线、IEPL/IPLC或者运营商提供的IDC互联专线。比如北京和上海各有一个GPU算力中心,可以在两地机房分别部署高性能核心交换机或路由器,通过运营商专线直接互联。带宽可以根据GPU集群规模选择100G、400G甚至更高规格。
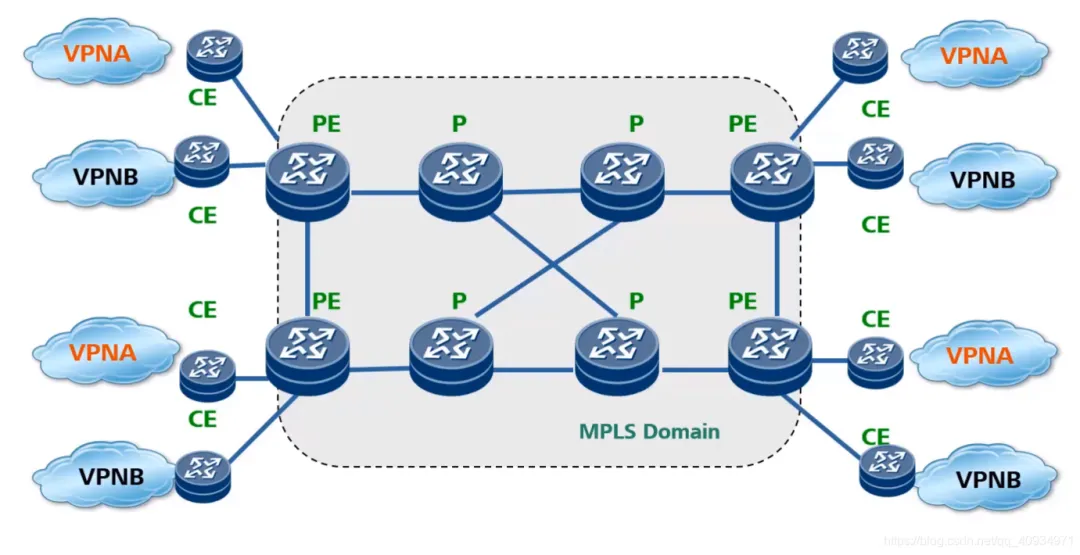
MPLS专线线路
其次是网络设备。GPU服务器通常会配置100G、200G、400G甚至800G网络接口,因此算力中心内部网络不能按照传统服务器机房的架构来设计。核心交换机、汇聚交换机、光模块以及专线接口,都需要匹配实际带宽,否则即使购买了400G专线,也可能因为机房内部网络只有100G而出现瓶颈。
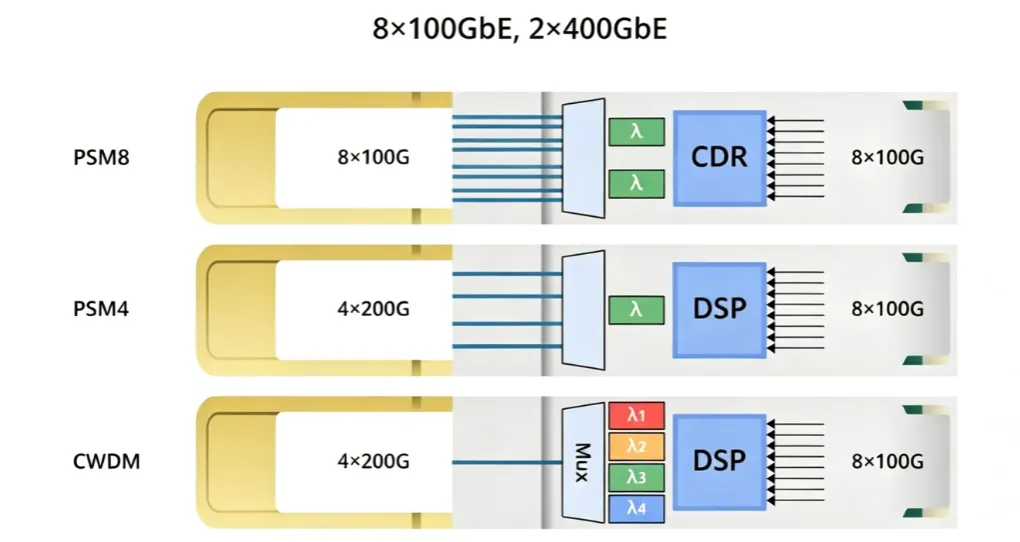
如果两个算力中心之间需要进行分布式训练,还要重点关注时延和丢包。带宽只是一个指标,网络稳定性同样重要。特别是跨省、跨区域甚至跨国互联,实际路径可能经过多个运营商节点,因此需要提前测试时延、抖动和丢包率,并尽量选择路由稳定的线路。
另外,建议做好链路冗余。核心算力业务不能只依赖一条专线,可以建设主备两条链路,分别经过不同的运营商或不同物理路径。当主链路出现故障时,自动切换到备用链路,降低网络中断对GPU集群任务的影响。
如果两个算力中心距离较近,还可以考虑数据中心之间的DCI互联;如果距离较远,则可以通过运营商骨干网络、专线或者OTN等方式实现跨区域高速连接。