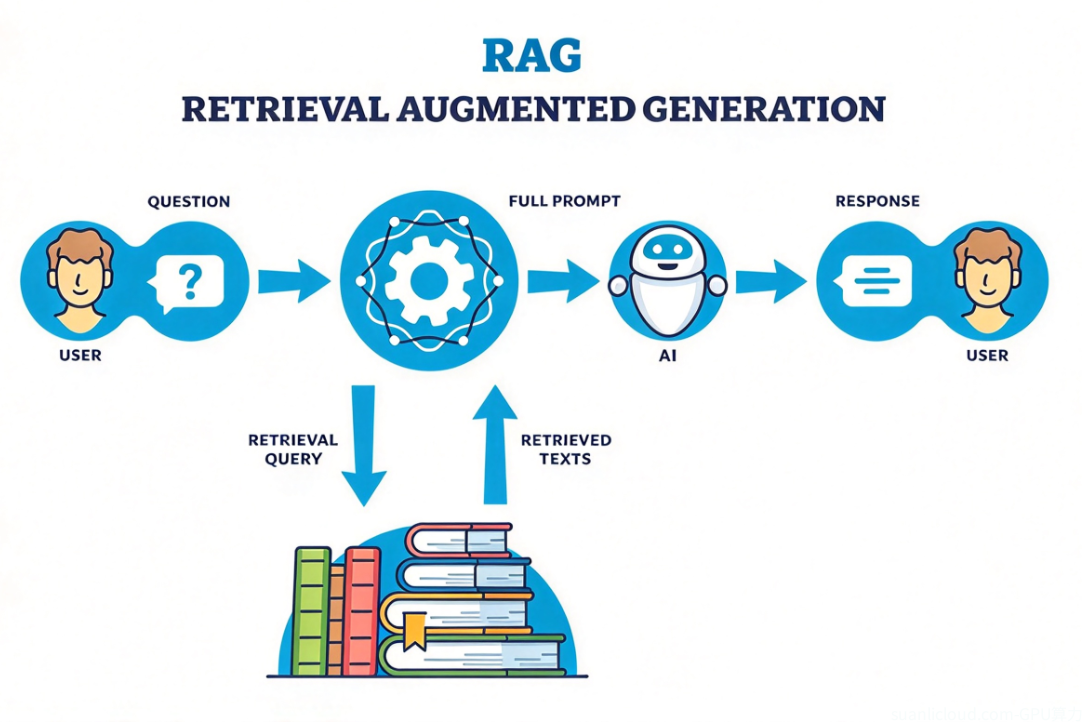
在企业 AI 知识库中,用户提出问题后,系统通常不会直接从所有文档中寻找答案,而是先通过检索技术找到一批相关内容,再进行筛选和排序。其中,Rerank(重排序)就是一个重要环节,它能够进一步判断检索结果与用户问题之间的相关程度,提高最终答案的准确性。
那么,为什么 AI 已经完成了知识检索,还需要进行一次重排序呢?
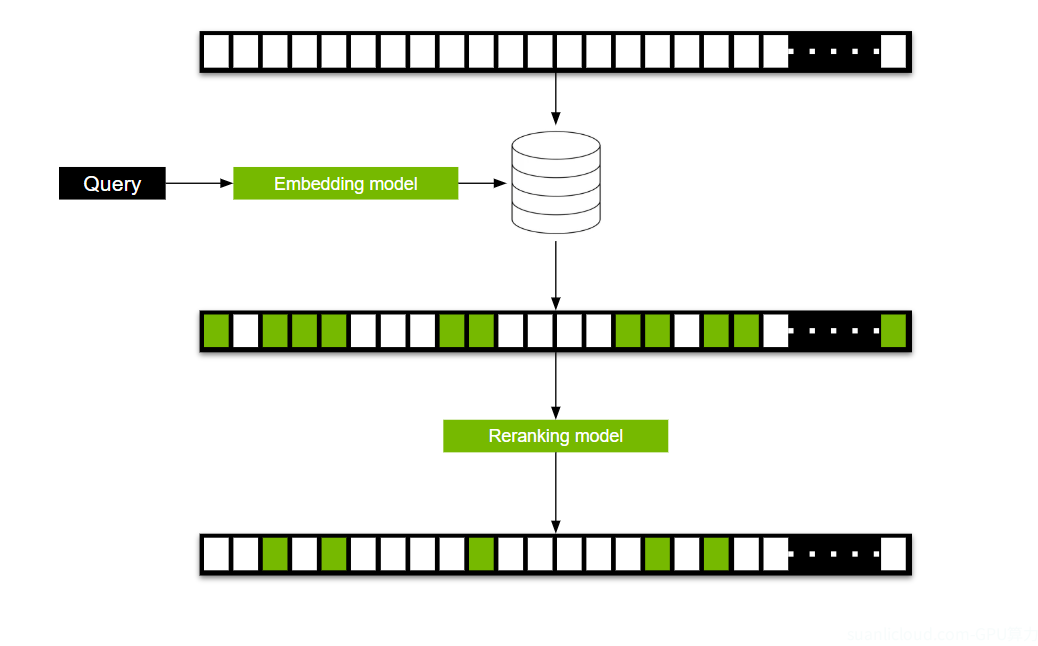
Rerank(重排序)
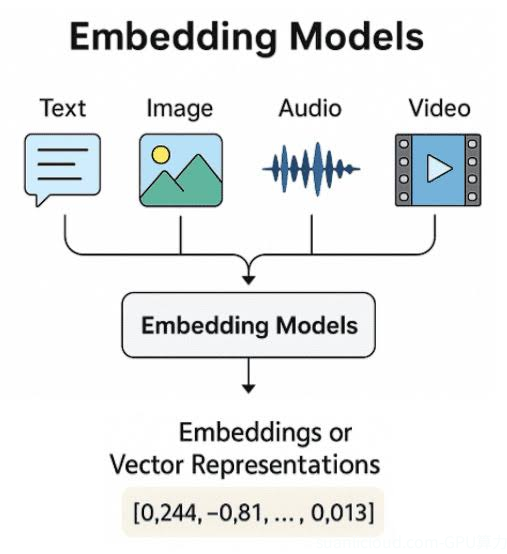
首先,传统的知识检索通常依靠关键词匹配或 Embedding 向量检索。系统会将用户的问题转换成向量,再与知识库中的文本向量进行相似度计算,找出一批相关内容。但向量相似度高,并不代表内容一定符合用户的实际需求。例如,用户询问“如何降低服务器运行成本”,系统可能检索到服务器租用价格、带宽费用、硬件采购等多个相关内容。这些内容虽然都与问题有关,但具体相关程度并不相同。
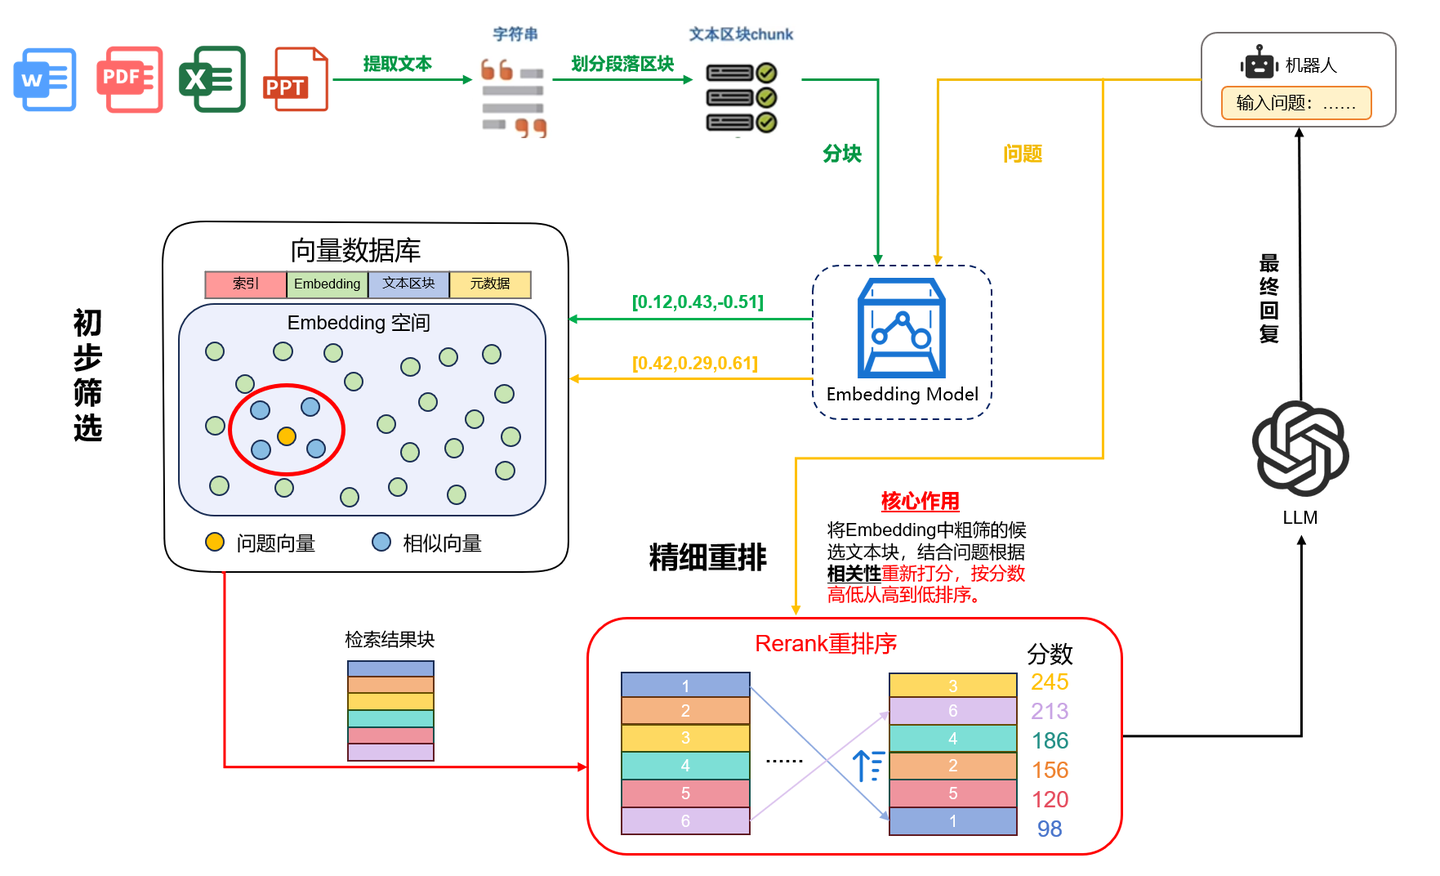
这时就需要 Rerank 模型进行二次判断。它会将用户的问题与第一轮检索出来的多个文本片段分别进行匹配分析,综合判断每段内容是否真正符合问题的语义和具体需求,然后重新计算相关性分数,并按照分数从高到低进行排列。
与普通向量检索不同,Rerank 通常采用 Cross-Encoder架构,将问题和候选文本放在一起进行联合分析,能够更细致地识别两者之间的语义关系。例如,用户询问“服务器怎样节省费用”,系统不仅能识别“服务器成本优化”,还可以判断“带宽计费方式”和“硬件采购成本”等内容是否真正符合当前问题。
在 RAG 知识库中,Rerank 通常位于向量检索之后、交给大模型生成答案之前。它可以从几十条甚至上百条初步检索结果中,筛选出相关性最高的几条内容,再交给大模型处理。
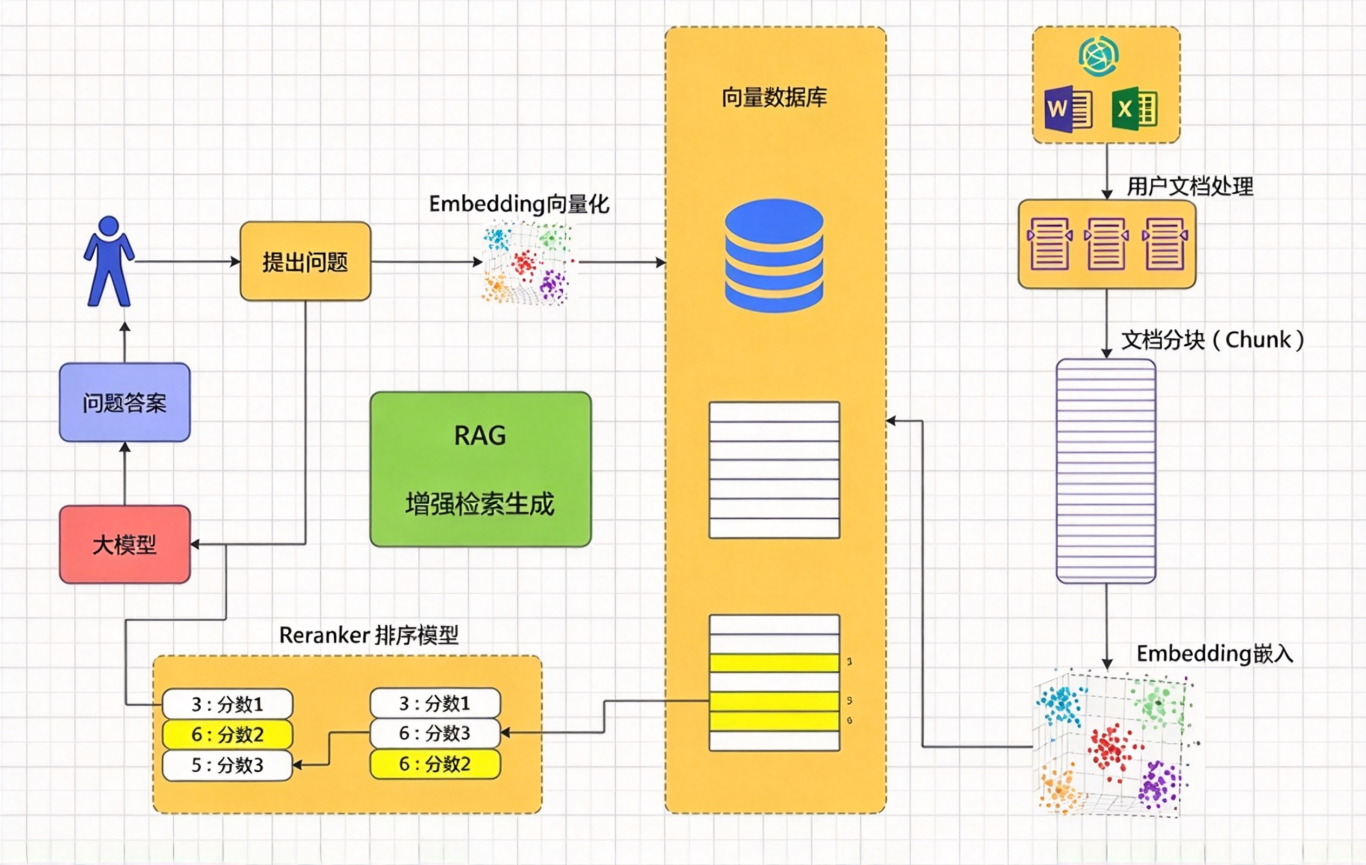
需要注意的是,Rerank 并不能保证答案绝对正确,它主要负责提高检索结果的相关性。如果知识库本身缺少准确内容,重新排序也无法补充不存在的信息。
总体来说,Rerank 解决的是检索结果不够精准的问题。通过增加这一环节,企业 AI 知识库能够减少无关内容进入大模型上下文的情况,让模型获得更有价值的参考资料,从而提升 RAG 系统的回答质量。